Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: test lokálních LLM na RTX 5060 Ti
Malé jazykové modely udělaly obrovský pokrok. Na běžné grafické kartě lze nyní lokálně provozovat modely, které dokážou zjišťovat informace o majetku, propojovat různá data nebo připravit akci v aplikaci.
Jedna otázka je ale užitečnější než žebříček benchmarků:
Klíčová otázka: který model skutečně funguje nejlépe v aplikaci, jako je My Wealth?
Porovnali jsme tři konfigurace nabízené v profilech AI služby My Wealth:
| Profil My Wealth | Model | Testovaná kvantizace |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Počet tokenů za sekundu je důležitý, prioritou je však přesná odpověď založená na datech portfolia a vytvořená pomocí správných nástrojů. Porovnáváme proto funkční úspěšnost, kvalitu odpovědí, potřebný čas a výkon ve Vulkanu a CUDA.
Testovací počítač
Všechny modely běžely lokálně na stejném počítači.
Grafická karta
NVIDIA GeForce RTX 5060 Ti 16 GB patří ke generaci Blackwell. Jejích 16 GB paměti GDDR7 umožňuje uchovat všechny tři kvantizované modely celé v GPU. NVIDIA nabízí kartu ve variantách 16 GB a 8 GB; použili jsme první z nich. Oficiální specifikace NVIDIA
Úplná konfigurace
| Součást | Naměřená konfigurace |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 MiB |
| CPU | AMD Ryzen 5 2600, 6 jader a 12 vláken |
| RAM | 31,9 GiB |
| Systém | Windows 11 Professional, sestavení 26200 |
| Ovladač NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, sestavení 10809 |
| Kontext | 32 768 tokenů |
| Backendy | nejprve Vulkan, poté CUDA |
Obrazový modul každého modelu byl vypnut. Všech patnáct případů je čistě textových, takže toto nastavení neplýtvá pamětí na nepoužívanou součást. Maximální pozorovaná spotřeba paměti GPU byla přibližně 7,7 GiB pro Qwen, 15,8 GiB pro Ministral a 12,0 GiB pro Gemma.
Tři modely
Qwen 3.5 9B — velmi rychlý malý model
Qwen 3.5 9B je z trojice nejkompaktnější. Oficiální repozitář jej popisuje jako multimodální konverzační model s licencí Apache 2.0. V našem textovém testu mu menší velikost dává výrazný náskok v rychlosti. Oficiální karta Qwen 3.5 9B
V tomto testu
Qwen používáme v Q4_K_M. Jde o nejdostupnější a nejrychlejší konfiguraci ve srovnání. Přímé požadavky zvládá dobře, ale při složitější orchestraci nebo zápisu je méně spolehlivý.
Ministral 3 14B Instruct 2512 — edge model od Mistral AI
Ministral 3 14B je největší testovaný model. Mistral jej určuje zejména pro lokální nasazení a edge; verze Instruct podporuje jedenáct jazyků a používá licenci Apache 2.0. Oficiální karta Ministral 3 14B Instruct
V tomto testu
Ministral používáme v Q5_K_M. Aby bylo srovnání Vulkan/CUDA symetrické a nevznikl problém s pamětí pozorovaný ve starším runtime, oba průchody využívají stejný engine llama.cpp 0.4.0 jako Gemma, bez obrazového modulu. Model zaplní téměř celých dostupných 16 GB, ale zůstává stabilní.
Gemma 4 12B — nejlepší výsledek srovnání
Gemma 4 12B je multimodální model Googlu s licencí Apache 2.0. Oficiální karta uvádí textové, zvukové, obrazové a video vstupy; zde používáme jen textovou část. Oficiální karta Gemma 4 12B
V tomto testu
Gemma používáme v Q6_K. Její velikost umožňuje zachovat větší přesnost než Ministral Q5 a současně se vejít do paměti karty. Je také jediným modelem, který uspěl v pokročilé akci.
Kvantizace jako proměnná pro přizpůsobení hardwaru
Modely netestujeme se stejnou kvantizací: Q4_K_M pro Qwen, Q5_K_M pro Ministral a Q6_K pro Gemma. Volba odpovídá konfiguracím skutečně použitelným v My Wealth a jejich cílovému hardwaru.
| Model | Kvantizace | Nejvyšší pozorovaná paměť GPU |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Benchmark tedy porovnává produktové konfigurace. Výsledky nemají izolovat pouze architekturu modelů.
Testovací protokol My Wealth
Úplná sada My Wealth obsahuje 354 otázek a akcí. 15 jsme pevně vybrali před měřením:
| Kategorie | Počet | Předmět |
|---|---|---|
| Basic | 8 | Přímé dotazy na majetek |
| Intermediate | 2 | Propojení více údajů |
| Advanced | 2 | Pokročilejší analýza a řetězce nástrojů |
| Write | 2 | Jednoduchá akce nebo bezpečné odmítnutí nemožné akce |
| Write Advanced | 1 | Úplné vytvoření s několika poli |
| Celkem | 15 |
Každá konfigurace zpracovala stejné případy, nejprve ve Vulkanu a potom v CUDA. Model zůstal načtený během všech patnácti testů. Zahřátí nebylo měřeno a syntetický majetek i konverzace se před každým případem resetovaly. Zachovali jsme jediný měřený pokus; chyba modelu zůstává výsledkem.
Co měříme
1. Funkční úspěšnost
Všech 90 výsledků jsme ručně zkontrolovali. U dotazu posuzujeme správnost a úplnost viditelné odpovědi vůči syntetickým datům. Nadbytečné volání nástroje nemění dobrou odpověď v neúspěch. U zápisu kontrolujeme skutečně uložený výsledek a všechna požadovaná pole: pouhé tvrzení o úspěchu nestačí.
2. Kvalita odpovědi
Viditelné odpovědi hodnotíme zvlášť podle správnosti, srozumitelnosti, věrnosti datům a užitečnosti. Toto lidské hodnocení určuje zveřejněné skóre.
3. Doba odezvy
Celkový čas zahrnuje výběr nástrojů, plánování, jejich volání a konečnou odpověď. Skutečné čekání vystihuje lépe než samotná rychlost generování.
4. Vulkan proti CUDA
Pro každý model používají oba průchody stejný GGUF, šablonu, engine i parametry. Mění se pouze backend GPU.
Výsledky — kvalita odpovědí
Celkový výsledek
| Konfigurace | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, tedy 60 % | 8/15, tedy 53 % |
| Ministral 3 14B Q5_K_M | 11/15, tedy 73 % | 11/15, tedy 73 % |
| Gemma 4 12B Q6_K | 13/15, tedy 87 % | 13/15, tedy 87 % |
Vítěz v kvalitě
Gemma 4 12B Q6_K dosahuje v obou backendech nejlepšího výsledku: 13 úspěchů z 15. Ministral je druhý s 11/15. Qwen získává 9/15 ve Vulkanu a 8/15 v CUDA.
Výsledky podle kategorií
Konkrétní příklad požadavku pro každou kategorii:
| Kategorie | Příklad testovaného požadavku |
|---|---|
| Basic | „Jaká je celková výše mých závazků?“ |
| Intermediate | „Porovnej hodnotu mých úspor s mými dluhy.“ |
| Advanced | „Pouze pro cíl Klidný důchod: jaký je jeho současný postup a požadované měsíční úsilí?“ |
| Write | „Přidej Crédit Mutuel mezi mé instituce.“ |
| Write Advanced | „Přidej u Banque Horizon produkt Compte Travaux […] vlastněný ze 100 % Benoîtem Martinem.“ |
| Model a backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Všechny tři modely selhávají ve dvou případech Write. První požadoval přidání instituce; žádný nedokončil změnu. Druhý chtěl přímo změnit hodnotu odvozenou od ceny zlata: modely měly vysvětlit, že samostatný zápis není podporován, jejich postup však pokračoval až k limitům generování či nástrojů.
Několik odpovědí, které nás překvapily
Příklad 1 — výborná pokročilá odpověď
U otázky na cíl „Klidný důchod“ najdou Ministral a Gemma obě očekávané hodnoty. Ministral mimo jiné odpovídá:
„Současný postup: 29,67 % […] Požadované měsíční úsilí: 858,88 €.“
Odpověď je krátká, číselná a založená na správném postupu dotazu.
Příklad 2 — věrohodná, ale chybná odpověď
Qwen tvrdí, že podíl aktiv financovaných závazky činí 13,70 % ve Vulkanu a 15,94 % v CUDA, očekávaná hodnota je však 17,81 %. Výpočty působí věrohodně, model ale vynechá část závazků nebo zvolí špatný jmenovatel.
Chyba ukazuje, proč přesvědčivá forma finanční odpovědi sama nestačí.
Příklad 3 — když rozhoduje použití nástrojů
Při vytvoření bankovního produktu „Compte Travaux“ Gemma ve Vulkanu i CUDA přesně uloží všechna pole: instituci, měnu, referenci, vklad, sledování, vlastníka a poznámku.
Ministral produkt vytvoří, ale ve skutečně uloženém výsledku vynechá instituci a poznámku, přestože tvrdí opak. Qwen neprovede žádnou změnu. Zápisy proto musíme kontrolovat podle uloženého stavu, nikoli jen konečného textu.
Výsledky — skutečná rychlost v My Wealth
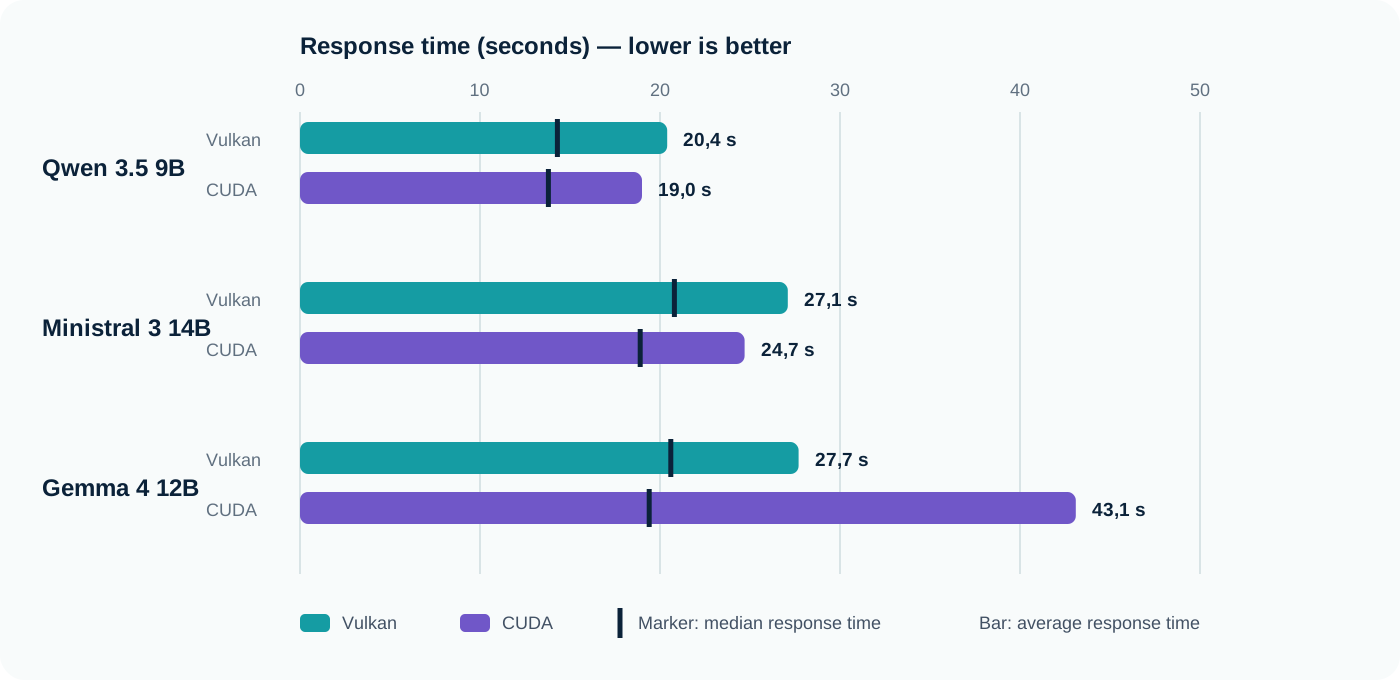
Doba odezvy
| Konfigurace | Průměr | Medián | Minimum | Maximum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vítěz v rychlosti
Qwen 3.5 9B v CUDA je nejrychlejší v průměru i mediánu. Gemma CUDA vyžaduje vysvětlení: medián je o něco lepší než ve Vulkanu, jeden případ však během plánování vygeneroval 8 192 tokenů a trval 4 min 33 s. Incident zvyšuje průměr na 43,1 s.
Vulkan vs CUDA
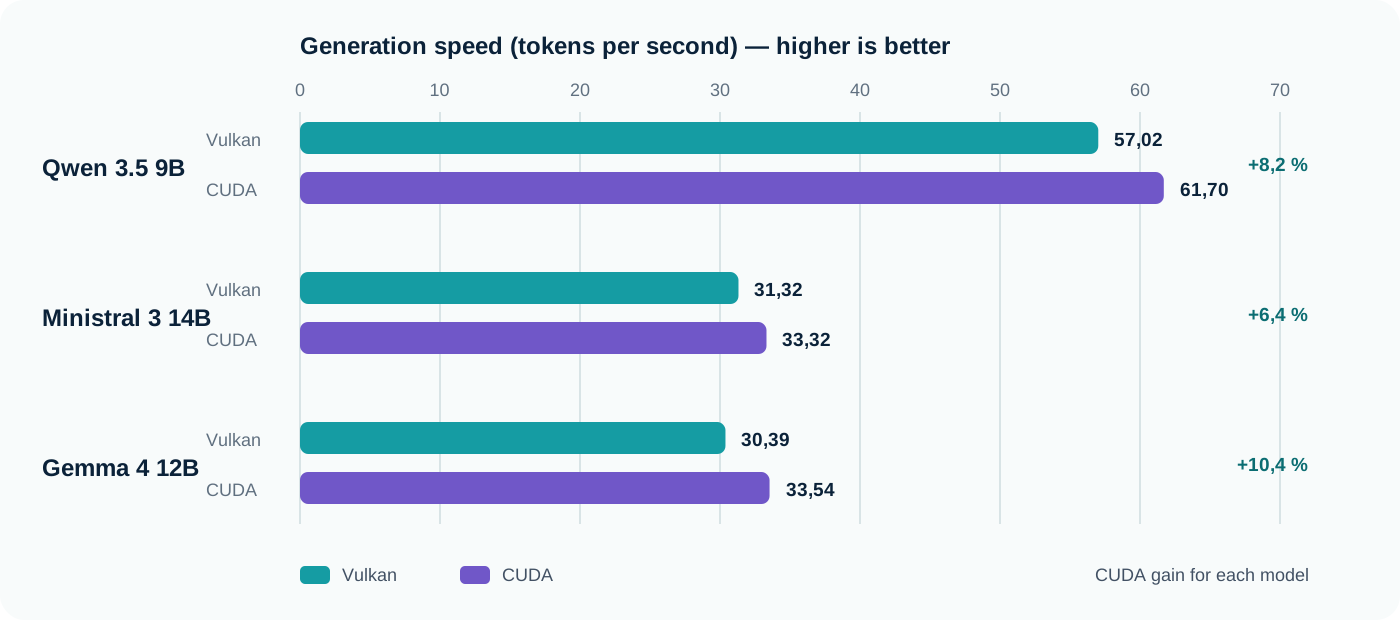
Generování: tokeny za sekundu
Propustnost počítáme vydělením celkového počtu tokenů celkovou dobou generování naměřenou llama.cpp. Nejde o prostý průměr rychlostí jednotlivých fází.
| Model | Vulkan | CUDA | Přínos CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok./s | 61,70 tok./s | +8,2 % |
| Ministral 3 14B | 31,32 tok./s | 33,32 tok./s | +6,4 % |
| Gemma 4 12B | 30,39 tok./s | 33,54 tok./s | +10,4 % |
CUDA vítězí v hrubé propustnosti u všech modelů. Nezaručuje však lepší celkový čas: rozhodování modelu a volání nástrojů často ovlivňují výsledek více než několik tokenů za sekundu.
Průměrná doba odezvy
CUDA zkracuje průměrný čas Qwen asi o 7 % a Ministral asi o 9 %. U Gemma incident při plánování zvyšuje průměr o 56 %, zatímco medián klesá asi o 5 %. Medián zde lépe popisuje obvyklé chování; maximum připomíná, že lokální asistent může občas spustit velmi dlouhé generování.
Vítězem nemusí být nejrychlejší model
Qwen generuje téměř dvakrát více tokenů za sekundu než ostatní modely, ale jeho lidské hodnocení je výrazně nižší. Ministral podstatně zvyšuje kvalitu bez nepřiměřeného čekání. Gemma má nejlepší skóre a jako jediná zvládá pokročilý zápis v obou backendech, za cenu nižší hrubé rychlosti a dlouhého incidentu v CUDA.
Nevytváříme svévolné složené skóre. Každé použití přikládá jinou váhu ušetřené sekundě, přesné odpovědi či správně provedené akci.
Který model zvolit?
Pokud je prioritou rychlost
Qwen 3.5 9B Q4_K_M v CUDA. Je rychlý a potřebuje výrazně méně paměti, ale skóre 8/15 vyžaduje pečlivou kontrolu složitějších požadavků.
Pro nejlepší rovnováhu
Ministral 3 14B Q5_K_M v CUDA. V obou backendech má 11/15 a CUDA snižuje medián na 18,9 s. Je to solidní kompromis pro dotazy a analýzy.
Pokud je nejdůležitější kvalita
Gemma 4 12B Q6_K ve Vulkanu. S 13/15 a úspěšnou pokročilou akcí srovnání vyhrává. V CUDA má stejné skóre, Vulkan se však vyhne incidentu při plánování, který silně zvyšuje průměr CUDA.
Závěr
Na RTX 5060 Ti 16 GB žádný model nevládne všem kritériím.
Qwen je vítězem rychlosti. Ministral nabízí nejstálejší kompromis mezi čekáním a kvalitou. Gemma ve Vulkanu dosahuje nejlepších funkčních výsledků a je nejpřesvědčivější ve složitých postupech.
Volba závisí na potřebě: rychlá odpověď pro jednoduché dotazy, vyvážený každodenní asistent, nebo nejvyšší priorita kvality a akcí. V našem srovnání Gemma 4 12B Q6_K vyhrává kvalitou v obou backendech; pro pravidelnost preferujeme Vulkan. Qwen 3.5 9B Q4_K_M v CUDA vyhrává rychlostí.