Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: comparativa de LLM locales en una RTX 5060 Ti
Los modelos de lenguaje pequeños han progresado enormemente. Ahora es posible ejecutar de forma local, en una tarjeta gráfica de consumo, modelos capaces de consultar un patrimonio, relacionar varios datos o incluso preparar una acción en una aplicación.
Pero hay una pregunta más útil que cualquier clasificación de benchmarks:
Pregunta clave: ¿qué modelo funciona realmente mejor en una aplicación como My Wealth?
Hemos enfrentado tres configuraciones propuestas por los perfiles de IA de My Wealth:
| Perfil de My Wealth | Modelo | Cuantización probada |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
La velocidad en tokens por segundo importa, pero la prioridad es obtener una respuesta exacta, basada en los datos de la cartera y producida con las herramientas adecuadas. Por ello comparamos el éxito funcional, la calidad de las respuestas, el tiempo necesario y el rendimiento con Vulkan y CUDA.
El equipo de prueba
Todos los modelos se ejecutaron localmente en el mismo equipo.
Tarjeta gráfica
La NVIDIA GeForce RTX 5060 Ti de 16 GB pertenece a la generación Blackwell. Sus 16 GB de GDDR7 permiten mantener íntegramente en la GPU los tres modelos cuantizados de esta comparativa. NVIDIA ofrece esta tarjeta en versiones de 16 GB y 8 GB; utilizamos la primera. Ficha oficial de NVIDIA
Configuración completa
| Componente | Configuración medida |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 núcleos y 12 hilos |
| RAM | 31,9 GiB |
| Sistema | Windows 11 Pro, compilación 26200 |
| Controlador NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, compilación 10809 |
| Contexto | 32.768 tokens |
| Backends | primero Vulkan y después CUDA |
El módulo de imagen de cada modelo se desactivó. Los quince casos son exclusivamente textuales y este ajuste evita ocupar memoria con un componente que no se utiliza. El máximo de memoria GPU observado durante las ejecuciones fue de aproximadamente 7,7 GiB para Qwen, 15,8 GiB para Ministral y 12,0 GiB para Gemma.
Los tres modelos
Qwen 3.5 9B: el pequeño modelo muy rápido
Qwen 3.5 9B es el más compacto de los tres. El repositorio oficial lo presenta como un modelo conversacional multimodal con licencia Apache 2.0. En nuestra prueba textual, su menor tamaño le aporta una clara ventaja de velocidad. Ficha oficial de Qwen 3.5 9B
En esta prueba
Utilizamos Qwen en Q4_K_M. Es la configuración más accesible y rápida de la comparativa. Resuelve bien las peticiones directas, pero es menos constante cuando la orquestación o la escritura se vuelven complejas.
Ministral 3 14B Instruct 2512: el modelo edge de Mistral AI
Ministral 3 14B es el modelo más grande de la prueba. Mistral lo destina especialmente a implementaciones locales y edge; su versión Instruct admite once idiomas y utiliza una licencia Apache 2.0. Ficha oficial de Ministral 3 14B Instruct
En esta prueba
Utilizamos Ministral en Q5_K_M. Para garantizar una comparación Vulkan/CUDA simétrica y evitar el problema de memoria detectado con su runtime anterior, ambas ejecuciones emplean el mismo motor llama.cpp 0.4.0 que Gemma, sin módulo de imagen. El modelo ocupa casi por completo los 16 GB disponibles, pero se mantiene estable.
Gemma 4 12B: la mejor puntuación de la comparativa
Gemma 4 12B es un modelo multimodal de Google con licencia Apache 2.0. Su ficha oficial describe entradas de texto, audio, imagen y vídeo; aquí solo utilizamos su parte textual. Ficha oficial de Gemma 4 12B
En esta prueba
Utilizamos Gemma en Q6_K. Su tamaño permite conservar más precisión que Ministral Q5 sin salir de la capacidad de memoria de la tarjeta. También es el único competidor que completa con éxito la acción avanzada.
La cuantización como variable de ajuste al hardware
Los tres modelos no se prueban con la misma cuantización: Q4_K_M para Qwen, Q5_K_M para Ministral y Q6_K para Gemma. Esta elección corresponde a los perfiles realmente utilizables en My Wealth y a su hardware objetivo.
| Modelo | Cuantización | Memoria GPU máxima observada |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Este benchmark compara, por tanto, configuraciones de producto. Los resultados no pretenden aislar únicamente la arquitectura de los modelos.
El protocolo de prueba de My Wealth
El banco completo de My Wealth contiene 354 preguntas y acciones. Seleccionamos 15 antes de realizar cualquier medición:
| Categoría | Número | Objeto |
|---|---|---|
| Basic | 8 | Consultas directas del patrimonio |
| Intermediate | 2 | Relación de varios datos |
| Advanced | 2 | Análisis y recorridos de herramientas más elaborados |
| Write | 2 | Acción sencilla o rechazo seguro de una acción imposible |
| Write Advanced | 1 | Creación completa con varios campos |
| Total | 15 |
Cada configuración procesó exactamente los mismos casos, primero con Vulkan y después con CUDA. El modelo permaneció cargado durante sus quince pruebas. Se excluyó una ejecución de calentamiento de las mediciones, y el patrimonio sintético y la conversación se reiniciaron para cada caso. Solo se tuvo en cuenta un intento medido; un error del modelo sigue siendo un resultado.
Qué medimos
1. Éxito funcional
Los 90 resultados se revisaron manualmente. Para una consulta, evaluamos la exactitud y la exhaustividad de la respuesta visible con respecto a los datos sintéticos. Una llamada redundante a una herramienta no convierte una buena respuesta en un fallo. Para una escritura, comprobamos el efecto realmente registrado y cada uno de los campos solicitados: no basta con afirmar que se ha realizado correctamente.
2. Calidad de la respuesta
Revisamos por separado las respuestas visibles: exactitud, claridad, fidelidad a los datos y utilidad. Esta revisión humana determina la puntuación publicada.
3. Tiempo de respuesta
El tiempo total incluye la selección de herramientas, la planificación, sus llamadas y la respuesta final. Refleja mejor la espera experimentada que una velocidad de generación aislada.
4. Vulkan frente a CUDA
Para cada modelo, ambas ejecuciones utilizan el mismo GGUF, la misma plantilla, el mismo motor y los mismos parámetros. Solo cambia el backend de la GPU.
Resultados: calidad de las respuestas
Resultado global
| Configuración | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, es decir, 60 % | 8/15, es decir, 53 % |
| Ministral 3 14B Q5_K_M | 11/15, es decir, 73 % | 11/15, es decir, 73 % |
| Gemma 4 12B Q6_K | 13/15, es decir, 87 % | 13/15, es decir, 87 % |
Ganador en calidad
Gemma 4 12B Q6_K obtiene el mejor resultado con ambos backends, con 13 aciertos de 15. Ministral queda segundo con 11/15. Qwen obtiene 9/15 con Vulkan y 8/15 con CUDA.
Resultados por categoría
Este es un ejemplo concreto de petición para cada categoría:
| Categoría | Ejemplo de petición probada |
|---|---|
| Basic | «¿Cuál es el importe total de mis pasivos?» |
| Intermediate | «Compara el valor de mis ahorros con el de mis deudas.» |
| Advanced | «Solo para el objetivo Jubilación tranquila, ¿cuál es su progreso actual y el esfuerzo mensual necesario?» |
| Write | «Añade “Crédit Mutuel” a mis entidades.» |
| Write Advanced | «Añade en Banque Horizon un soporte “Cuenta Obras” […] propiedad al 100 % de Benoît Martin.» |
| Modelo y backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Los tres modelos fallan en los dos casos Write. El primero pedía añadir una entidad; ninguno completó la modificación. El segundo pedía modificar directamente un valor derivado de la cotización del oro: los modelos deberían haber explicado con claridad que esa escritura aislada no estaba admitida, pero sus recorridos se prolongaron hasta alcanzar los límites de generación o de herramientas.
Algunas respuestas que nos sorprendieron
Ejemplo 1: una excelente respuesta avanzada
Ante la pregunta sobre el objetivo «Jubilación tranquila», Ministral y Gemma encuentran los dos valores esperados. Ministral responde, en particular:
«Progreso actual: 29,67 % […] Esfuerzo mensual necesario: 858,88 €.»
La respuesta es breve, cuantificada y se basa en el recorrido de consulta correcto.
Ejemplo 2: una respuesta plausible… pero incorrecta
Qwen responde que la parte de los activos financiada por los pasivos es del 13,70 % con Vulkan y del 15,94 % con CUDA, cuando el valor esperado es del 17,81 %. Los cálculos parecen creíbles, pero el modelo omite parte de los pasivos o elige un denominador equivocado.
Este error ilustra por qué no basta con que una respuesta financiera parezca convincente.
Ejemplo 3: cuando el uso de las herramientas marca la diferencia
Ante la petición de crear el soporte bancario «Cuenta Obras», Gemma aplica exactamente todos los campos solicitados tanto con Vulkan como con CUDA: entidad, divisa, referencia, aportación, seguimiento, propietario y nota.
Ministral crea un soporte, pero omite la entidad y la nota en el efecto realmente registrado, pese a que su respuesta afirma lo contrario. Qwen no aplica ninguna modificación. Este ejemplo muestra por qué la revisión de las escrituras debe centrarse en el estado registrado, no solo en el texto final.
Resultados: velocidad real en My Wealth
Tiempo de respuesta
| Configuración | Media | Mediana | Mínimo | Máximo |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
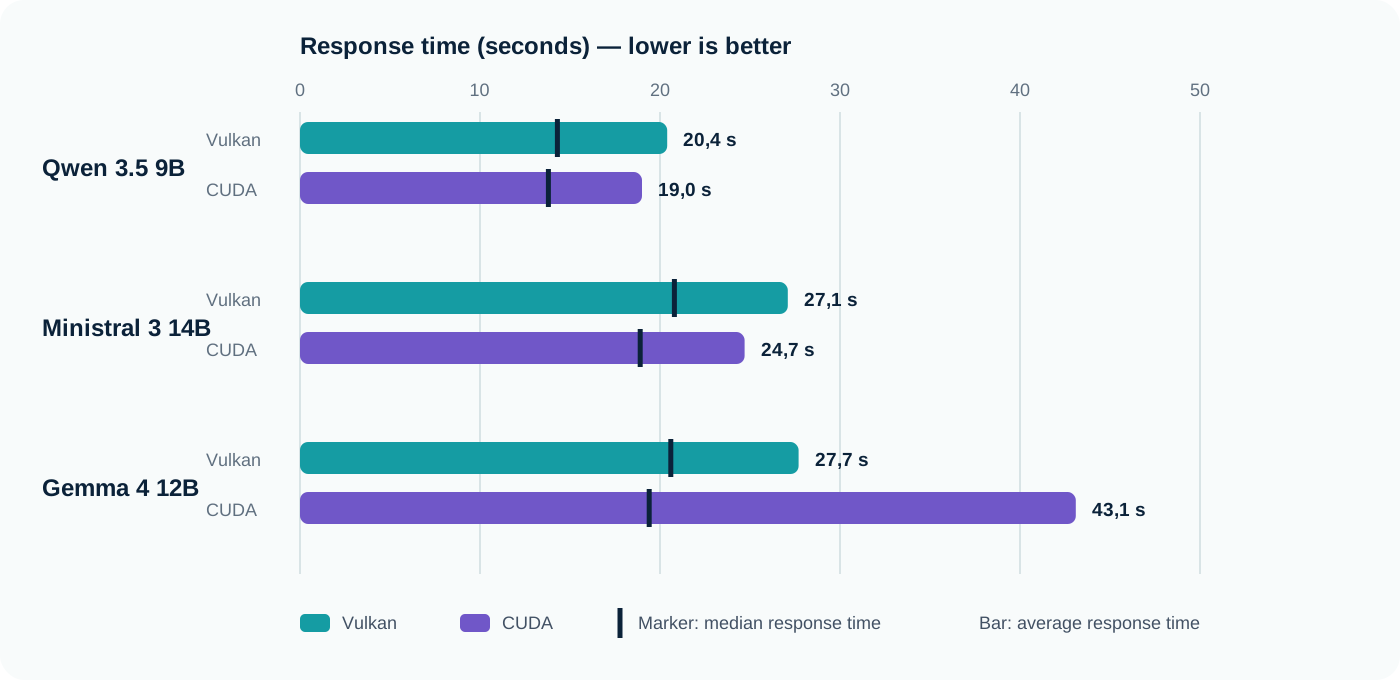
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Ganador en velocidad
Qwen 3.5 9B con CUDA es el más rápido, tanto de media como en la mediana. Gemma CUDA merece una explicación: su mediana es ligeramente mejor que con Vulkan, pero un caso generó 8.192 tokens durante una fase de planificación y duró 4 min 33 s. Este incidente eleva su media a 43,1 s.
Vulkan vs CUDA
Generación: tokens por segundo
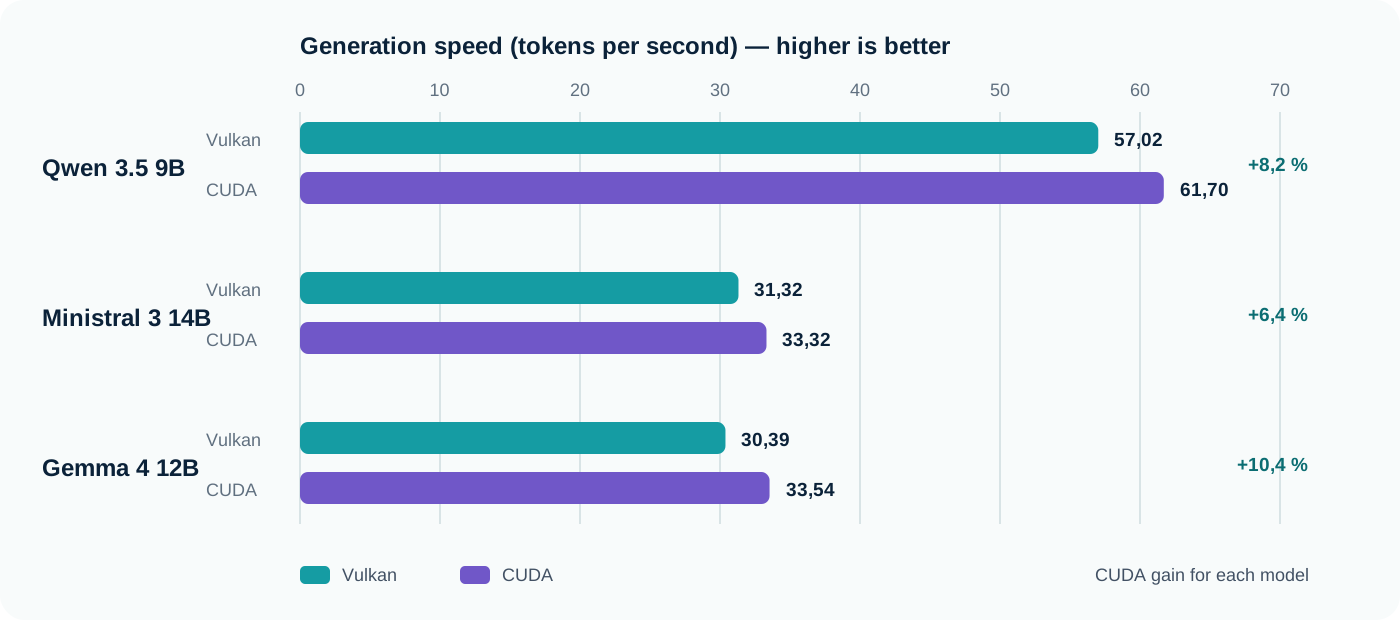
La velocidad se agrega dividiendo el total de tokens generados por la duración total de generación medida por llama.cpp. No se trata de una media simple de las velocidades de cada fase.
| Modelo | Vulkan | CUDA | Mejora con CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA gana en velocidad bruta con los tres modelos. Sin embargo, esto no garantiza un mejor tiempo total: las decisiones del modelo y las llamadas a herramientas suelen pesar más que unos cuantos tokens por segundo.
Tiempo medio de respuesta
CUDA reduce el tiempo medio de Qwen cerca de un 7 % y el de Ministral alrededor de un 9 %. En Gemma, el incidente de planificación aumenta la media un 56 %, mientras que la mediana disminuye cerca de un 5 %. Aquí la mediana describe mejor el comportamiento habitual; el máximo recuerda que un asistente local puede emprender ocasionalmente una generación muy larga.
El ganador no es necesariamente el modelo más rápido
Qwen produce casi el doble de tokens por segundo que los otros dos modelos, pero su puntuación humana es claramente inferior. Ministral ofrece una mejora importante de la calidad sin perjudicar demasiado la espera. Gemma obtiene la mejor puntuación y completa con éxito la única escritura avanzada en ambos backends, a costa de una menor velocidad bruta y un incidente prolongado con CUDA.
No calculamos una puntuación compuesta arbitraria. No todos los usos atribuyen el mismo valor a un segundo ahorrado, una respuesta exacta o una acción ejecutada correctamente.
¿Qué modelo elegir?
Para dar prioridad a la velocidad
Qwen 3.5 9B Q4_K_M con CUDA. Es rápido y necesita mucha menos memoria, pero su 8/15 exige una verificación cuidadosa en cuanto la petición va más allá de una consulta sencilla.
Para obtener el mejor equilibrio
Ministral 3 14B Q5_K_M con CUDA. Su puntuación se mantiene en 11/15 con ambos backends y CUDA reduce su mediana a 18,9 s. Es un compromiso sólido para consultas y análisis.
Para dar prioridad absoluta a la calidad
Gemma 4 12B Q6_K con Vulkan. Con 13/15 y la acción avanzada completada, gana esta comparativa. Gemma obtiene la misma puntuación con CUDA, pero Vulkan evita el incidente de planificación que alarga considerablemente la media de CUDA.
Conclusión
En esta RTX 5060 Ti de 16 GB, ningún modelo domina todos los criterios.
Qwen es el campeón de la velocidad. Ministral ofrece el compromiso más constante entre espera y calidad. Gemma con Vulkan proporciona los mejores resultados funcionales y es el más convincente para los recorridos complejos.
Por tanto, la elección depende de la necesidad: respuesta rápida para consultas sencillas, equilibrio para un asistente cotidiano o máxima prioridad para la calidad y las acciones. En nuestra comparativa, Gemma 4 12B Q6_K gana en calidad con ambos backends; preferimos Vulkan por su regularidad. Qwen 3.5 9B Q4_K_M con CUDA gana en velocidad.