Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: test lokalnih LLM-ova na RTX 5060 Ti
Mali jezični modeli iznimno su napredovali. Danas je na grafičkoj kartici za široku potrošnju moguće lokalno pokretati modele koji mogu pretraživati imovinu, povezivati više podataka ili pripremiti radnju u aplikaciji.
No jedno je pitanje korisnije od poretka na testovima performansi:
Ključno pitanje: koji model doista najbolje radi u aplikaciji kao što je My Wealth?
Usporedili smo tri konfiguracije koje nude AI profili u aplikaciji My Wealth:
| Profil My Wealth | Model | Testirana kvantizacija |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Brzina u tokenima po sekundi važna je, ali prioritet je dobiti točan odgovor koji se temelji na podacima portfelja i izrađen je uz odgovarajuće alate. Stoga uspoređujemo funkcionalnu uspješnost, kvalitetu odgovora, potrebno vrijeme te performanse uz Vulkan i CUDA.
Testno računalo
Svi su modeli pokrenuti lokalno na istom računalu.
Grafička kartica
NVIDIA GeForce RTX 5060 Ti 16 GB pripada generaciji Blackwell. Njezinih 16 GB memorije GDDR7 omogućuje da se sva tri kvantizirana modela iz ove usporedbe u cijelosti zadrže u GPU-u. NVIDIA nudi ovu karticu u inačicama sa 16 GB i 8 GB; upotrijebili smo prvu. Službena stranica proizvoda NVIDIA
Potpuna konfiguracija
| Komponenta | Izmjerena konfiguracija |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 jezgri i 12 dretvi |
| RAM | 31,9 GiB |
| Sustav | Windows 11 Professional, međuverzija 26200 |
| NVIDIA upravljački program | 616.56 |
| Izvršno okruženje | llama.cpp 0.4.0, međuverzija 10809 |
| Kontekst | 32.768 tokena |
| Pozadinski sustavi | Najprije Vulkan, zatim CUDA |
Modul za obradu slika svakog modela bio je isključen. Svih petnaest slučajeva isključivo je tekstualno, a tom se postavkom izbjegava zauzimanje memorije komponentom koja se ne upotrebljava. Najveća zabilježena potrošnja GPU memorije tijekom izvođenja iznosila je približno 7,7 GiB za Qwen, 15,8 GiB za Ministral i 12,0 GiB za Gemmu.
Tri modela
Qwen 3.5 9B — vrlo brz mali model
Qwen 3.5 9B najkompaktniji je od triju modela. Službeni repozitorij predstavlja ga kao multimodalni razgovorni model pod licencom Apache 2.0. U našem tekstualnom testu njegova mu manja veličina daje jasnu prednost u brzini. Službena stranica modela Qwen 3.5 9B
U ovom testu
Qwen upotrebljavamo u kvantizaciji Q4_K_M. To je najpristupačnija i najbrža konfiguracija u usporedbi. Dobro izvršava izravne zahtjeve, ali postaje manje dosljedan čim orkestracija ili zapisivanje postanu složeniji.
Ministral 3 14B Instruct 2512 — rubni model tvrtke Mistral AI
Ministral 3 14B najveći je testirani model. Mistral ga namjenjuje, među ostalim, lokalnim i rubnim implementacijama; inačica Instruct podržava jedanaest jezika i upotrebljava licencu Apache 2.0. Službena stranica modela Ministral 3 14B Instruct
U ovom testu
Ministral upotrebljavamo u kvantizaciji Q5_K_M. Kako bi usporedba Vulkan/CUDA bila simetrična i kako bismo izbjegli problem s memorijom uočen u njegovu prijašnjem izvršnom okruženju, oba izvođenja upotrebljavaju isti pogon llama.cpp 0.4.0 kao Gemma, bez modula za obradu slika. Model zauzima gotovo svih dostupnih 16 GB, ali ostaje stabilan.
Gemma 4 12B — najbolji rezultat u ovoj usporedbi
Gemma 4 12B multimodalni je Googleov model pod licencom Apache 2.0. Na službenoj stranici navedeni su tekstualni, zvučni, slikovni i video ulazi; ovdje upotrebljavamo samo njegov tekstualni dio. Službena stranica modela Gemma 4 12B
U ovom testu
Gemmu upotrebljavamo u kvantizaciji Q6_K. Njezina veličina omogućuje zadržavanje veće preciznosti nego kod modela Ministral Q5, uz ostanak unutar memorijskih mogućnosti kartice. To je ujedno jedini kandidat koji uspješno izvršava naprednu radnju.
Kvantizacija kao način prilagodbe hardveru
Tri modela nisu testirana s istom kvantizacijom: Q4_K_M za Qwen, Q5_K_M za Ministral i Q6_K za Gemmu. Taj izbor odgovara profilima koji se stvarno mogu upotrebljavati u aplikaciji My Wealth i hardveru kojem su namijenjeni.
| Model | Kvantizacija | Najveća zabilježena GPU memorija |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Ovaj test stoga uspoređuje konfiguracije proizvoda. Rezultati ne tvrde da izdvajaju samo arhitekturu modela.
Protokol testiranja aplikacije My Wealth
Cjelokupni skup testova aplikacije My Wealth sadržava 354 pitanja i radnje. Njih smo 15 zaključali prije bilo kakvog mjerenja:
| Kategorija | Broj | Predmet |
|---|---|---|
| Basic | 8 | Izravni upiti o imovini |
| Intermediate | 2 | Povezivanje više podataka |
| Advanced | 2 | Složenija analiza i tijekovi s alatima |
| Write | 2 | Jednostavna radnja ili sigurno odbijanje nemoguće radnje |
| Write Advanced | 1 | Potpuno stvaranje s više polja |
| Ukupno | 15 |
Svaka je konfiguracija obradila potpuno iste slučajeve, najprije uz Vulkan, a zatim uz CUDA. Model je ostao učitan tijekom svojih petnaest testova. Jedno zagrijavanje nije uključeno u mjerenja, a sintetička imovina i razgovor ponovno su postavljeni za svaki slučaj. Zadržan je samo jedan izmjereni pokušaj; pogreška modela i dalje je rezultat.
Što mjerimo
1. Funkcionalna uspješnost
Svih 90 rezultata ručno je pregledano. Pri upitu ocjenjujemo točnost i potpunost vidljivog odgovora u odnosu na sintetičke podatke. Suvišan poziv alata ne pretvara dobar odgovor u neuspjeh. Pri zapisivanju provjeravamo stvarno zabilježeni učinak i svako traženo polje: samo navesti da je radnja uspjela nije dovoljno.
2. Kvaliteta odgovora
Vidljive odgovore pregledavamo zasebno: točnost, jasnoću, vjernost podacima i korisnost. Ta ljudska provjera određuje objavljenu ocjenu.
3. Vrijeme odziva
Ukupno vrijeme obuhvaća odabir alata, planiranje, njihove pozive i završni odgovor. Ono bolje predstavlja čekanje koje korisnik doživljava nego zasebno promatrana brzina generiranja.
4. Vulkan u odnosu na CUDA
Za svaki model oba izvođenja upotrebljavaju isti GGUF, isti predložak, isti pogon i iste parametre. Mijenja se samo GPU pozadinski sustav.
Rezultati — kvaliteta odgovora
Ukupni rezultat
| Konfiguracija | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, odnosno 60 % | 8/15, odnosno 53 % |
| Ministral 3 14B Q5_K_M | 11/15, odnosno 73 % | 11/15, odnosno 73 % |
| Gemma 4 12B Q6_K | 13/15, odnosno 87 % | 13/15, odnosno 87 % |
Pobjednik u kvaliteti
Gemma 4 12B Q6_K postiže najbolji rezultat uz oba pozadinska sustava, s 13 uspješnih slučajeva od 15. Ministral je drugi s rezultatom 11/15. Qwen postiže 9/15 uz Vulkan i 8/15 uz CUDA.
Rezultati po kategoriji
Slijedi konkretan primjer testiranog zahtjeva za svaku kategoriju:
| Kategorija | Primjer testiranog zahtjeva |
|---|---|
| Basic | „Koliki je ukupan iznos mojih obveza?” |
| Intermediate | „Usporedi vrijednost moje štednje s vrijednošću mojih dugova.” |
| Advanced | „Koji su trenutačni napredak i potreban mjesečni iznos samo za cilj Mirna mirovina?” |
| Write | „Dodaj ‘Crédit Mutuel’ među moje ustanove.” |
| Write Advanced | „Dodaj u Banque Horizon instrument ‘Compte Travaux’ […] u stopostotnom vlasništvu Benoîta Martina.” |
| Model i pozadinski sustav | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Sva tri modela neuspješna su u dva slučaja Write. U prvom je trebalo dodati ustanovu; nijedan model nije dovršio promjenu. U drugom je trebalo izravno izmijeniti vrijednost izvedenu iz cijene zlata. Modeli su trebali jasno objasniti da takvo izdvojeno zapisivanje nije podržano, ali njihovi su se tijekovi nastavili sve do ograničenja generiranja ili alata.
Nekoliko odgovora koji su nas iznenadili
Primjer 1 — izvrstan napredni odgovor
Na pitanje o cilju „Mirna mirovina” Ministral i Gemma pronalaze dvije očekivane vrijednosti. Ministral, među ostalim, odgovara:
„Trenutačni napredak: 29,67 % […] Potreban mjesečni iznos: 858,88 €.”
Odgovor je kratak, brojčano precizan i temelji se na ispravnom tijeku upita.
Primjer 2 — uvjerljiv odgovor… koji je netočan
Qwen odgovara da udio imovine financiran obvezama iznosi 13,70 % uz Vulkan i 15,94 % uz CUDA, dok je očekivana vrijednost 17,81 %. Izračuni djeluju vjerodostojno, ali model izostavlja dio obveza ili odabire pogrešan nazivnik.
Ta pogreška pokazuje zašto uvjerljiv oblik financijskog odgovora nije dovoljan.
Primjer 3 — kada upotreba alata čini razliku
Na zahtjev za stvaranje bankovnog instrumenta „Compte Travaux” Gemma i uz Vulkan i uz CUDA primjenjuje točno sva tražena polja: ustanovu, valutu, referencu, uplatu, praćenje, vlasnika i bilješku.
Ministral stvara instrument, ali u stvarno zabilježenom učinku izostavlja ustanovu i bilješku, unatoč odgovoru koji tvrdi suprotno. Qwen ne primjenjuje nikakvu promjenu. Taj primjer pokazuje zašto se zapisivanje mora provjeravati prema spremljenom stanju, a ne samo prema završnom tekstu.
Rezultati — stvarna brzina u aplikaciji My Wealth
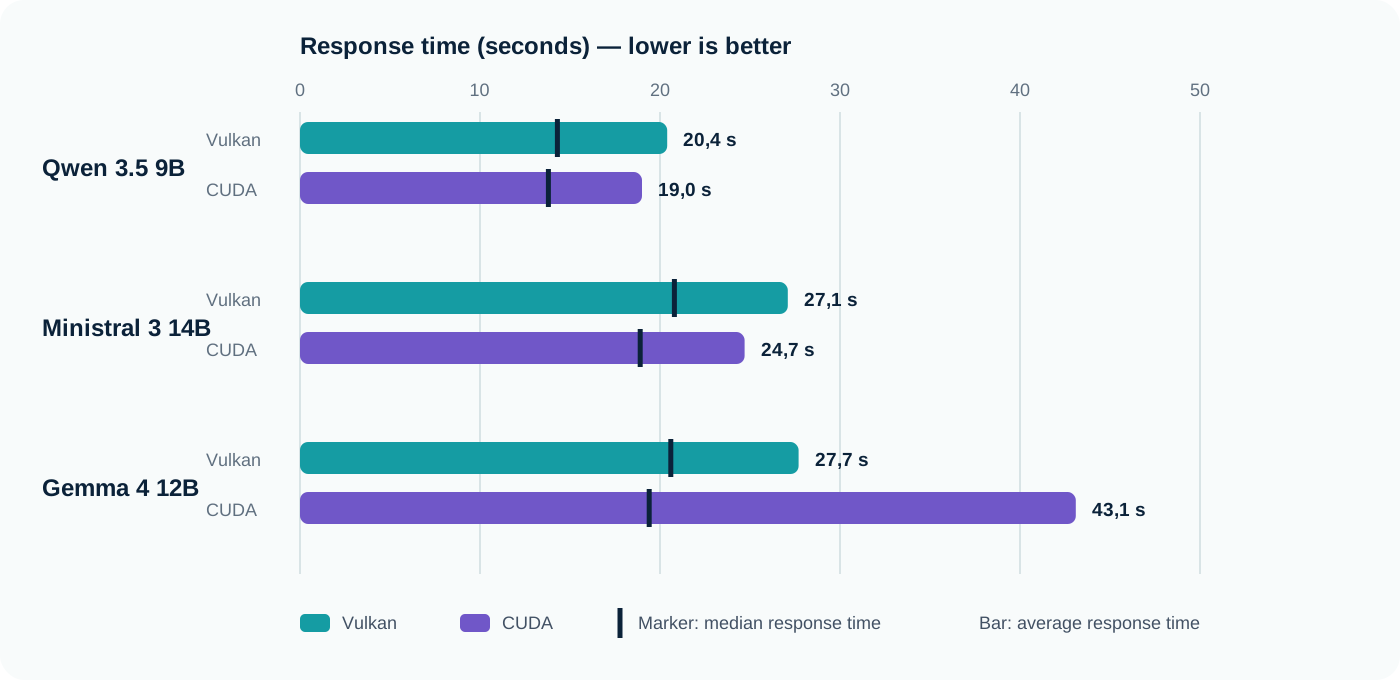
Vrijeme odziva
| Konfiguracija | Prosjek | Medijan | Minimum | Maksimum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Pobjednik u brzini
Qwen 3.5 9B uz CUDA najbrži je i prema prosjeku i prema medijanu. Rezultat modela Gemma uz CUDA zahtijeva objašnjenje: njegov je medijan nešto bolji nego uz Vulkan, ali u jednom je slučaju tijekom faze planiranja generirano 8.192 tokena, a izvođenje je trajalo 4 min 33 s. Taj incident podiže prosjek na 43,1 s.
Vulkan vs CUDA
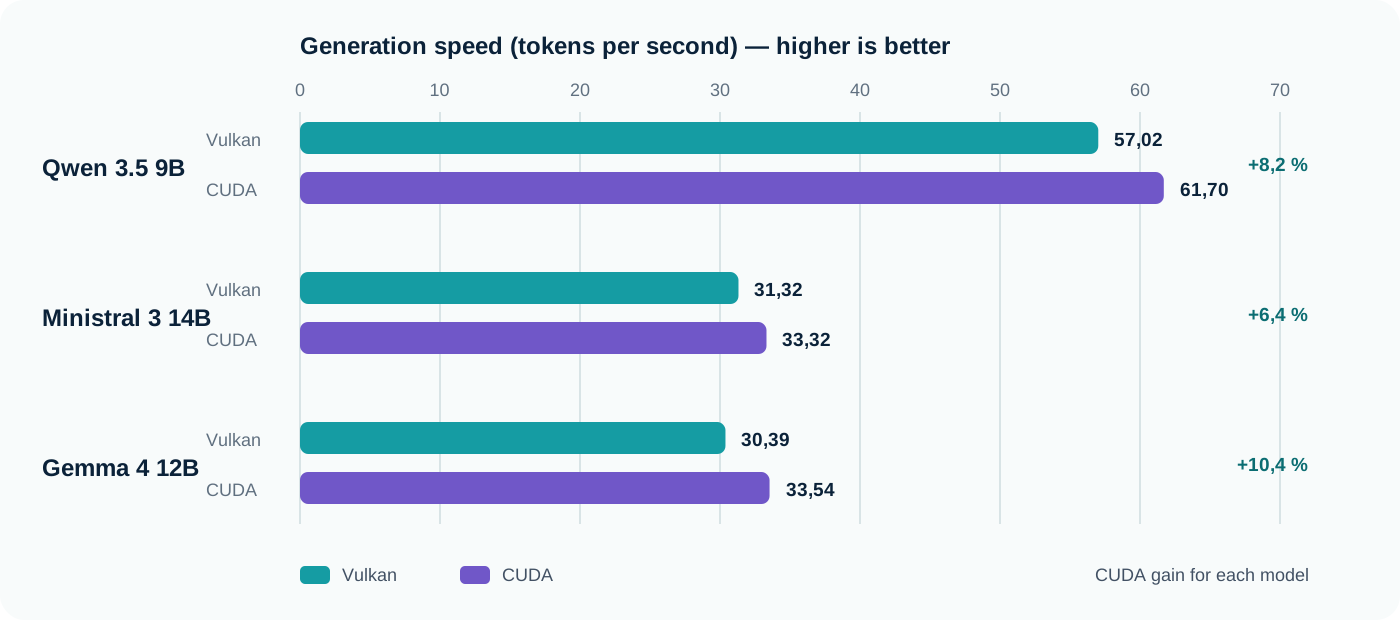
Generiranje: tokeni po sekundi
Brzina je agregirana dijeljenjem ukupnog broja generiranih tokena s ukupnim trajanjem generiranja koje je izmjerio llama.cpp. Nije riječ o jednostavnom prosjeku brzina svake faze.
| Model | Vulkan | CUDA | Dobitak uz CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA pobjeđuje u sirovoj propusnosti kod sva tri modela. To ipak ne jamči bolje ukupno vrijeme: odluke modela i pozivi alata često imaju veći utjecaj od nekoliko tokena po sekundi.
Prosječno vrijeme odziva
CUDA smanjuje Qwenovo prosječno vrijeme za približno 7 %, a Ministralovo za približno 9 %. Kod Gemme incident u planiranju povećava prosjek za 56 %, dok se medijan smanjuje za približno 5 %. Medijan ovdje bolje opisuje uobičajeno ponašanje; maksimum podsjeća da lokalni asistent povremeno može krenuti u vrlo dugo generiranje.
Pobjednik nije nužno najbrži model
Qwen proizvodi gotovo dvostruko više tokena po sekundi od drugih dvaju modela, ali njegova je ocjena ljudskih pregledavatelja znatno niža. Ministral donosi važno poboljšanje kvalitete bez pretjeranog produljenja čekanja. Gemma postiže najbolji rezultat i uz oba pozadinska sustava uspješno izvršava jedino napredno zapisivanje, po cijenu manje sirove brzine i jednog dugog incidenta uz CUDA.
Ne izračunavamo proizvoljnu složenu ocjenu. Ne pridaju svi slučajevi upotrebe jednaku vrijednost ušteđenoj sekundi, točnom odgovoru ili ispravno izvršenoj radnji.
Koji model odabrati?
Kada prednost dajete brzini
Qwen 3.5 9B Q4_K_M uz CUDA. Brz je i zahtijeva znatno manje memorije, ali njegov rezultat 8/15 traži pažljivu provjeru čim zahtjev nadilazi jednostavan upit.
Za najbolju ravnotežu
Ministral 3 14B Q5_K_M uz CUDA. Njegov rezultat ostaje 11/15 uz oba pozadinska sustava, a CUDA smanjuje medijan na 18,9 s. To je dobar kompromis za upite i analitička pitanja.
Kada prednost prije svega dajete kvaliteti
Gemma 4 12B Q6_K uz Vulkan. S rezultatom 13/15 i uspješno izvršenom naprednom radnjom pobjeđuje u ovoj usporedbi. Gemma postiže isti rezultat uz CUDA, ali Vulkan izbjegava incident u planiranju koji snažno povećava prosjek za CUDA.
Zaključak
Na ovoj kartici RTX 5060 Ti 16 GB nijedan model ne dominira u svim kriterijima.
Qwen je prvak u brzini. Ministral nudi najdosljedniji kompromis između čekanja i kvalitete. Gemma uz Vulkan daje najbolje funkcionalne rezultate i najuvjerljivija je u složenim tijekovima.
Odabir stoga ovisi o potrebi: brz odgovor za jednostavne upite, ravnoteža za svakodnevnog asistenta ili najveća prednost kvaliteti i radnjama. U našoj usporedbi Gemma 4 12B Q6_K pobjeđuje u kvaliteti uz oba pozadinska sustava; prednost dajemo Vulkanu zbog njegove dosljednosti. Qwen 3.5 9B Q4_K_M uz CUDA pobjeđuje u brzini.