Qwen 3.5 9B, Ministral 3 14B ar Gemma 4 12B: vietinių LLM palyginimas su RTX 5060 Ti
Mažieji kalbos modeliai padarė milžinišką pažangą. Dabar įprastoje vaizdo plokštėje galima vietoje paleisti modelius, gebančius pateikti užklausas apie turtą, susieti kelis duomenis ar net parengti veiksmą programoje.
Tačiau vienas klausimas yra naudingesnis už vietą etaloninių testų lentelėje:
Pagrindinis klausimas: kuris modelis iš tikrųjų geriausiai veikia tokioje programoje kaip „My Wealth“?
Palyginome tris „My Wealth“ DI profiliuose siūlomas konfigūracijas:
| „My Wealth“ profilis | Modelis | Išbandyta kvantizacija |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Žetonų skaičius per sekundę yra svarbus, tačiau pirmiausia reikia tikslaus, portfelio duomenimis pagrįsto ir tinkamais įrankiais parengto atsakymo. Todėl lyginame funkcinę sėkmę, atsakymų kokybę, reikalingą laiką ir našumą naudojant Vulkan bei CUDA.
Bandymų kompiuteris
Visi modeliai buvo paleisti vietoje tame pačiame kompiuteryje.
Vaizdo plokštė
NVIDIA GeForce RTX 5060 Ti 16 GB priklauso Blackwell kartai. Jos 16 GB GDDR7 atmintyje galima visiškai sutalpinti visus tris šiame palyginime naudojamus kvantizuotus modelius. NVIDIA siūlo šią plokštę su 16 GB ir 8 GB atminties; naudojome pirmąją versiją. Oficialus NVIDIA aprašas
Visa konfigūracija
| Komponentas | Išmatuota konfigūracija |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 Mio |
| CPU | AMD Ryzen 5 2600, 6 branduoliai ir 12 gijų |
| RAM | 31,9 Gio |
| Sistema | Windows 11 Professional, build 26200 |
| NVIDIA tvarkyklė | 616.56 |
| Vykdymo aplinka | llama.cpp 0.4.0, build 10809 |
| Kontekstas | 32 768 žetonai |
| Posistemės | iš pradžių Vulkan, tada CUDA |
Kiekvieno modelio vaizdų apdorojimo modulis buvo išjungtas. Visi penkiolika scenarijų yra vien tekstiniai, todėl šis nustatymas neleidžia eikvoti atminties nenaudojamam komponentui. Didžiausias bandymų metu stebėtas GPU atminties naudojimas siekė apie 7,7 Gio su Qwen, 15,8 Gio su Ministral ir 12,0 Gio su Gemma.
Trys modeliai
Qwen 3.5 9B – labai greitas mažasis modelis
Qwen 3.5 9B yra kompaktiškiausias iš trijų modelių. Oficialiame repozitorijoje jis pristatomas kaip pokalbiams skirtas daugiarūšis modelis, platinamas pagal Apache 2.0 licenciją. Mūsų tekstiniame bandyme dėl mažesnio dydžio jis akivaizdžiai pirmauja greičiu. Oficialus Qwen 3.5 9B aprašas
Šiame bandyme
Qwen naudojame su Q4_K_M kvantizacija. Tai prieinamiausia ir greičiausia palyginimo konfigūracija. Ji gerai įvykdo tiesiogines užklausas, tačiau tampa ne tokia stabili, kai orkestravimas arba duomenų įrašymas yra sudėtingesnis.
Ministral 3 14B Instruct 2512 – Mistral AI kraštinių įrenginių modelis
Ministral 3 14B yra didžiausias išbandytas modelis. Mistral jį skiria, be kita ko, vietiniam diegimui ir kraštiniams įrenginiams; Instruct versija palaiko vienuolika kalbų ir naudoja Apache 2.0 licenciją. Oficialus Ministral 3 14B Instruct aprašas
Šiame bandyme
Ministral naudojame su Q5_K_M kvantizacija. Kad Vulkan ir CUDA palyginimas būtų simetriškas ir nekiltų su ankstesne vykdymo aplinka pastebėta atminties problema, abiem bandymams naudojamas tas pats llama.cpp 0.4.0 variklis kaip ir Gemma, be vaizdų apdorojimo modulio. Modelis užima beveik visus prieinamus 16 GB, tačiau išlieka stabilus.
Gemma 4 12B – geriausią šio palyginimo rezultatą pasiekęs modelis
Gemma 4 12B yra Google daugiarūšis modelis, platinamas pagal Apache 2.0 licenciją. Oficialiame jo apraše nurodoma, kad galima pateikti tekstą, garsą, vaizdus ir vaizdo įrašus; čia naudojama tik tekstinė jo dalis. Oficialus Gemma 4 12B aprašas
Šiame bandyme
Gemma naudojame su Q6_K kvantizacija. Dėl savo dydžio jis išsaugo daugiau tikslumo nei Ministral Q5 ir kartu telpa vaizdo plokštės atmintyje. Be to, tai vienintelis dalyvis, sėkmingai įvykdęs sudėtingą veiksmą.
Kvantizacija kaip derinimo prie aparatinės įrangos kintamasis
Trys modeliai bandomi ne su ta pačia kvantizacija: Q4_K_M skirta Qwen, Q5_K_M – Ministral, o Q6_K – Gemma. Šis pasirinkimas atitinka realiai „My Wealth“ naudojamus profilius ir jiems numatytą aparatinę įrangą.
| Modelis | Kvantizacija | Didžiausias stebėtas GPU atminties naudojimas |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 Gio |
| Ministral 3 14B | Q5_K_M | 15,8 Gio |
| Gemma 4 12B | Q6_K | 12,0 Gio |
Taigi šiame etaloniniame teste lyginamos produkto konfigūracijos. Rezultatais nesiekiama atskirai įvertinti tik pačių modelių architektūros.
„My Wealth“ bandymų metodika
Visą „My Wealth“ bandymų rinkinį sudaro 354 klausimai ir veiksmai. Prieš pradėdami bet kokius matavimus atrinkome 15:
| Kategorija | Skaičius | Tikslas |
|---|---|---|
| Basic | 8 | Tiesioginės turto užklausos |
| Intermediate | 2 | Kelių duomenų susiejimas |
| Advanced | 2 | Sudėtingesnė analizė ir įrankių naudojimo eiga |
| Write | 2 | Paprastas veiksmas arba saugus neįmanomo veiksmo atsisakymas |
| Write Advanced | 1 | Visapusis kūrimas nurodant kelis laukus |
| Iš viso | 15 |
Kiekviena konfigūracija apdorojo lygiai tuos pačius scenarijus: pirmiausia su Vulkan, o tada su CUDA. Modelis likdavo įkeltas visus penkiolika bandymų. Vienas apšilimo paleidimas nebuvo įtrauktas į matavimus, o sintetinis turtas ir pokalbis buvo iš naujo nustatomi prieš kiekvieną scenarijų. Į rezultatą įtrauktas tik vienas išmatuotas bandymas; modelio klaida taip pat laikoma rezultatu.
Ką matuojame
1. Funkcinė sėkmė
Visi 90 rezultatų buvo peržiūrėti rankiniu būdu. Užklausos atveju vertiname naudotojui matomo atsakymo tikslumą ir išsamumą, palyginti su sintetiniais duomenimis. Perteklinis įrankio iškvietimas gero atsakymo nepaverčia nesėkme. Įrašymo atveju tikriname realiai išsaugotą rezultatą ir kiekvieną prašytą lauką – vien teiginio, kad veiksmas sėkmingas, nepakanka.
2. Atsakymo kokybė
Naudotojui matomus atsakymus peržiūrime atskirai: vertiname tikslumą, aiškumą, atitiktį duomenims ir naudingumą. Šia žmonių atliekama peržiūra nustatomas skelbiamas įvertinimas.
3. Atsako laikas
Bendras laikas apima įrankių parinkimą, planavimą, jų iškvietimą ir galutinį atsakymą. Jis tikroviškiau atspindi naudotojo laukimą nei vien generavimo sparta.
4. Vulkan ir CUDA palyginimas
Kiekvieno modelio abiem bandymams naudojamas tas pats GGUF, tas pats šablonas, tas pats variklis ir tie patys parametrai. Keičiasi tik GPU posistemė.
Rezultatai – atsakymų kokybė
Bendras rezultatas
| Konfigūracija | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, arba 60 % | 8/15, arba 53 % |
| Ministral 3 14B Q5_K_M | 11/15, arba 73 % | 11/15, arba 73 % |
| Gemma 4 12B Q6_K | 13/15, arba 87 % | 13/15, arba 87 % |
Kokybės laimėtojas
Gemma 4 12B Q6_K pasiekia geriausią rezultatą su abiem posistemėmis – 13 sėkmingų bandymų iš 15. Ministral užima antrą vietą su 11/15. Qwen pasiekia 9/15 su Vulkan ir 8/15 su CUDA.
Rezultatai pagal kategoriją
Toliau pateikiamas konkretus kiekvienos kategorijos išbandytos užklausos pavyzdys:
| Kategorija | Išbandytos užklausos pavyzdys |
|---|---|
| Basic | „Kokia bendra mano įsipareigojimų suma?“ |
| Intermediate | „Palygink mano santaupų vertę su mano skolomis.“ |
| Advanced | „Kokia yra vienintelio tikslo „Retraite sereine“ dabartinė pažanga ir kokių mėnesinių pastangų jam reikia?“ |
| Write | „Pridėk „Crédit Mutuel“ prie mano įstaigų.“ |
| Write Advanced | „Banke „Banque Horizon“ pridėk priemonę „Compte Travaux“ […] kuri 100 % priklauso Benoît Martin.“ |
| Modelis ir posistemė | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Visiems trims modeliams nepavyksta įveikti abiejų Write scenarijų. Pirmuoju buvo prašoma pridėti įstaigą; nė vienas modelis neužbaigė pakeitimo. Antruoju buvo prašoma tiesiogiai pakeisti iš aukso kurso išvestą vertę: modeliai turėjo aiškiai paaiškinti, kad toks atskiras įrašymas nepalaikomas, tačiau jų vykdomi veiksmai tęsėsi, kol buvo pasiektas generavimo arba įrankių apribojimas.
Keli mus nustebinę atsakymai
1 pavyzdys – puikus atsakymas į sudėtingą užklausą
Paklausus apie tikslą „Retraite sereine“, Ministral ir Gemma randa abi tikėtinas reikšmes. Ministral atsako:
„Dabartinė pažanga: 29,67 % […] Reikalingos mėnesinės pastangos: 858,88 €.“
Atsakymas yra trumpas, pagrįstas skaičiais ir gautas tinkamai įvykdžius užklausą.
2 pavyzdys – tikėtinas, bet klaidingas atsakymas
Qwen atsako, kad įsipareigojimais finansuojamo turto dalis naudojant Vulkan yra 13,70 %, o naudojant CUDA – 15,94 %, nors tikėtina reikšmė yra 17,81 %. Skaičiavimai atrodo įtikinami, tačiau modelis praleidžia dalį įsipareigojimų arba pasirenka netinkamą vardiklį.
Ši klaida parodo, kodėl įtikinamos finansinio atsakymo formos nepakanka.
3 pavyzdys – kai įrankių naudojimas lemia skirtumą
Gavęs prašymą sukurti banko priemonę „Compte Travaux“, Gemma ir su Vulkan, ir su CUDA tiksliai pritaiko visus prašytus laukus: įstaigą, valiutą, nuorodą, įmoką, stebėjimą, savininką ir pastabą.
Ministral priemonę sukuria, tačiau realiai išsaugotame rezultate praleidžia įstaigą ir pastabą, nors atsakyme teigia priešingai. Qwen nepritaiko jokio pakeitimo. Šis pavyzdys rodo, kodėl peržiūrint įrašymo veiksmus reikia tikrinti išsaugotą būseną, o ne vien galutinį tekstą.
Rezultatai – realus greitis „My Wealth“ programoje
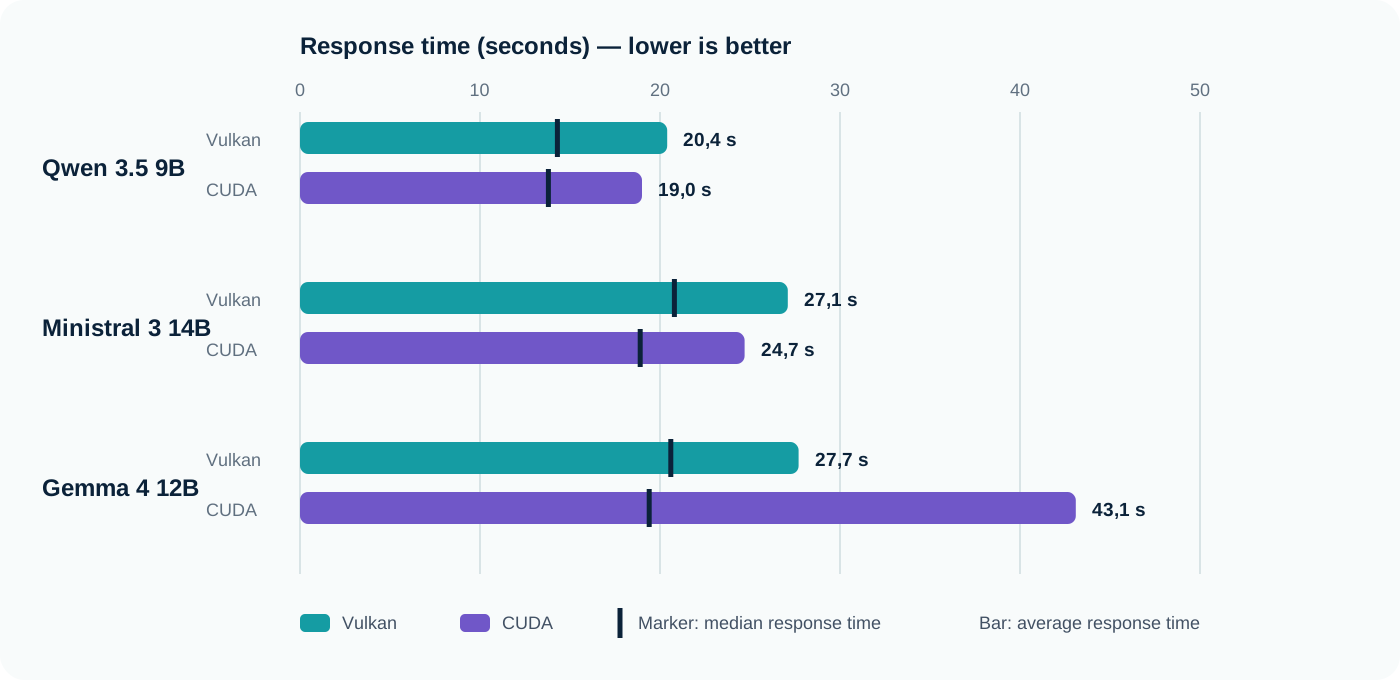
Atsako laikas
| Konfigūracija | Vidurkis | Mediana | Mažiausia reikšmė | Didžiausia reikšmė |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Greičio laimėtojas
Qwen 3.5 9B su CUDA yra greičiausias ir pagal vidurkį, ir pagal medianą. Gemma CUDA rezultatą reikia paaiškinti: jo mediana yra šiek tiek geresnė nei su Vulkan, tačiau vienu scenarijumi planavimo etape buvo sugeneruoti 8 192 žetonai, todėl jis truko 4 min. 33 s. Dėl šio incidento vidurkis išauga iki 43,1 s.
Vulkan ir CUDA palyginimas
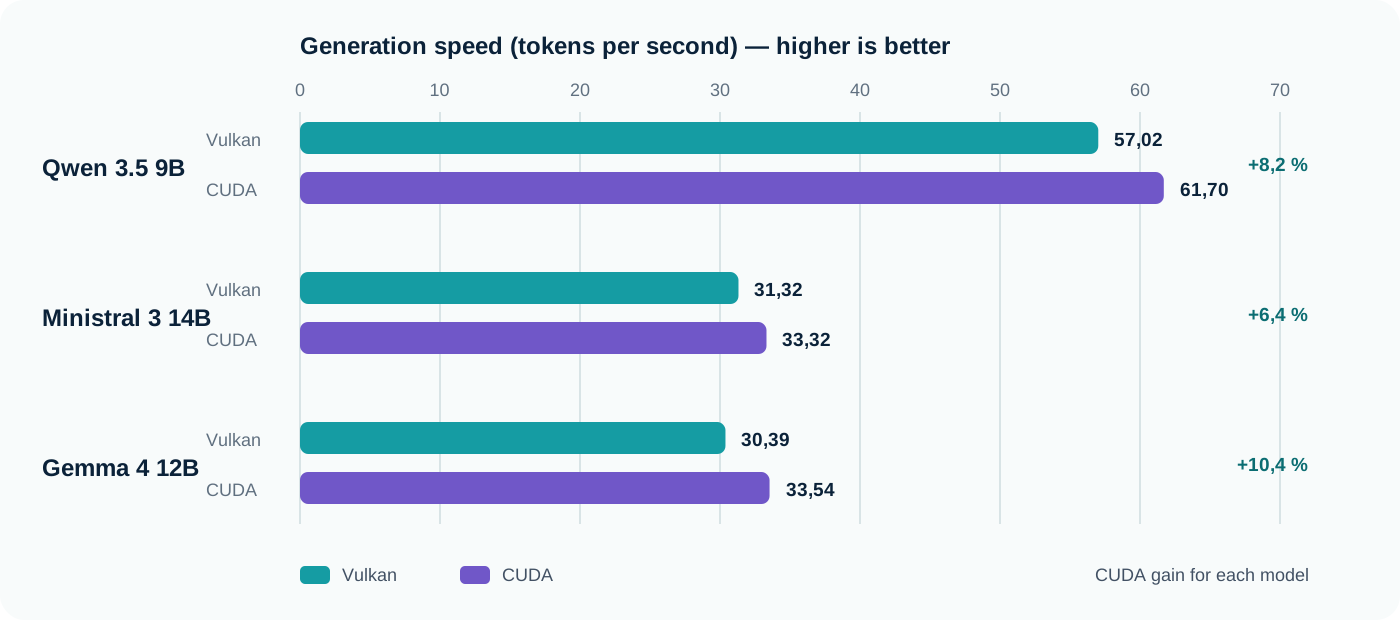
Generavimas: žetonai per sekundę
Sparta apskaičiuojama visą sugeneruotų žetonų skaičių padalijus iš visos llama.cpp išmatuotos generavimo trukmės. Tai nėra paprastas kiekvieno etapo spartos vidurkis.
| Modelis | Vulkan | CUDA | CUDA pagreitėjimas |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
Pagal neapdorotą spartą CUDA laimi su visais trimis modeliais. Vis dėlto tai negarantuoja geresnio bendro laiko: modelio sprendimai ir įrankių iškvietimai dažnai lemia daugiau nei keli papildomi žetonai per sekundę.
Vidutinis atsako laikas
CUDA sutrumpina vidutinį Qwen atsako laiką apie 7 %, o Ministral – apie 9 %. Gemma atveju dėl planavimo incidento vidurkis padidėja 56 %, nors mediana sumažėja apie 5 %. Šiuo atveju mediana geriau apibūdina įprastą veikimą, o didžiausia reikšmė primena, kad vietinis asistentas kartais gali pradėti labai ilgą generavimą.
Laimėtojas nebūtinai yra greičiausias modelis
Qwen sugeneruoja beveik dvigubai daugiau žetonų per sekundę nei kiti du modeliai, tačiau žmonių skirtas jo įvertinimas yra gerokai prastesnis. Ministral reikšmingai pagerina kokybę pernelyg nepadidindamas laukimo. Gemma pasiekia geriausią rezultatą ir vienintelis sėkmingai įvykdo sudėtingą įrašymą su abiem posistemėmis, tačiau jo neapdorota sparta yra mažesnė, o naudojant CUDA įvyko ilgai trukęs incidentas.
Neskaičiuojame savavališko bendro įvertinimo. Ne visais naudojimo atvejais vienodai vertinama sutaupyta sekundė, tikslus atsakymas ar tinkamai įvykdytas veiksmas.
Kurį modelį pasirinkti?
Kai svarbiausia greitis
Qwen 3.5 9B Q4_K_M su CUDA. Jis yra greitas ir naudoja gerokai mažiau atminties, tačiau 8/15 rezultatas reiškia, kad užklausą reikia atidžiai patikrinti vos tik ji tampa sudėtingesnė už paprastą duomenų peržiūrą.
Siekiant geriausio balanso
Ministral 3 14B Q5_K_M su CUDA. Su abiem posistemėmis jo rezultatas išlieka 11/15, o CUDA sumažina medianą iki 18,9 s. Tai tvirtas kompromisas duomenų peržiūros ir analizės klausimams.
Kai svarbiausia kokybė
Gemma 4 12B Q6_K su Vulkan. Pasiekęs 13/15 ir sėkmingai įvykdęs sudėtingą veiksmą, jis laimi šį palyginimą. Gemma gauna tokį patį įvertinimą su CUDA, tačiau Vulkan padeda išvengti planavimo incidento, kuris smarkiai padidina CUDA vidurkį.
Išvada
Šiame kompiuteryje su RTX 5060 Ti 16 GB nė vienas modelis nedominuoja pagal visus kriterijus.
Qwen yra greičio čempionas. Ministral siūlo stabiliausią laukimo ir kokybės kompromisą. Gemma su Vulkan pasiekia geriausius funkcinius rezultatus ir yra įtikinamiausias sudėtingose veiksmų sekose.
Taigi pasirinkimas priklauso nuo poreikio: greitas atsakymas į paprastas užklausas, balansas kasdieniam asistentui arba didžiausias dėmesys kokybei ir veiksmams. Mūsų palyginime Gemma 4 12B Q6_K laimi pagal kokybę su abiem posistemėmis; dėl stabilumo teikiame pirmenybę Vulkan. Qwen 3.5 9B Q4_K_M su CUDA laimi pagal greitį.