Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: test lokalnych LLM na RTX 5060 Ti
Małe modele językowe poczyniły ogromne postępy. Dziś na popularnej karcie graficznej można lokalnie uruchamiać modele zdolne analizować majątek, zestawiać różne dane, a nawet przygotowywać działania w aplikacji.
Jedno pytanie jest jednak bardziej użyteczne niż ranking benchmarków:
Kluczowe pytanie: który model rzeczywiście sprawdza się najlepiej w aplikacji takiej jak My Wealth?
Porównaliśmy trzy konfiguracje oferowane w profilach AI My Wealth:
| Profil My Wealth | Model | Testowana kwantyzacja |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Liczba tokenów na sekundę ma znaczenie, ale priorytetem jest poprawna odpowiedź oparta na danych portfela i uzyskana przy użyciu właściwych narzędzi. Porównujemy więc skuteczność funkcjonalną, jakość odpowiedzi, wymagany czas oraz wydajność w Vulkan i CUDA.
Komputer testowy
Wszystkie modele uruchomiono lokalnie na tym samym komputerze.
Karta graficzna
NVIDIA GeForce RTX 5060 Ti 16 GB należy do generacji Blackwell. Jej 16 GB pamięci GDDR7 pozwala w całości zmieścić na GPU trzy skwantyzowane modele z tego porównania. NVIDIA oferuje tę kartę w wariantach 16 GB i 8 GB; użyliśmy pierwszego z nich. Oficjalna specyfikacja NVIDIA
Pełna konfiguracja
| Komponent | Zmierzona konfiguracja |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 MiB |
| CPU | AMD Ryzen 5 2600, 6 rdzeni i 12 wątków |
| RAM | 31,9 GiB |
| System | Windows 11 Professional, kompilacja 26200 |
| Sterownik NVIDIA | 616.56 |
| Środowisko | llama.cpp 0.4.0, kompilacja 10809 |
| Kontekst | 32 768 tokenów |
| Backendy | najpierw Vulkan, potem CUDA |
Moduł obrazu każdego modelu został wyłączony. Wszystkie piętnaście przypadków ma charakter wyłącznie tekstowy, więc takie ustawienie nie zajmuje pamięci nieużywanym komponentem. Maksymalne zaobserwowane użycie pamięci GPU wyniosło około 7,7 GiB dla Qwen, 15,8 GiB dla Ministral i 12,0 GiB dla Gemma.
Trzy modele
Qwen 3.5 9B — bardzo szybki mały model
Qwen 3.5 9B jest najbardziej kompaktowy z całej trójki. Oficjalne repozytorium przedstawia go jako multimodalny model konwersacyjny na licencji Apache 2.0. W naszym teście tekstowym niewielki rozmiar daje mu wyraźną przewagę pod względem szybkości. Oficjalna karta Qwen 3.5 9B
W tym teście
Używamy Qwen w wersji Q4_K_M. To najbardziej dostępna i najszybsza konfiguracja w porównaniu. Dobrze radzi sobie z bezpośrednimi poleceniami, lecz staje się mniej niezawodna, gdy orkiestracja lub zapis danych są bardziej złożone.
Ministral 3 14B Instruct 2512 — model edge od Mistral AI
Ministral 3 14B jest największym z testowanych modeli. Mistral przeznacza go między innymi do wdrożeń lokalnych i edge; wersja Instruct obsługuje jedenaście języków i korzysta z licencji Apache 2.0. Oficjalna karta Ministral 3 14B Instruct
W tym teście
Używamy Ministral w wersji Q5_K_M. Aby zapewnić symetryczne porównanie Vulkan/CUDA i uniknąć problemu z pamięcią zauważonego w jego starszym środowisku, oba przebiegi korzystają z tego samego silnika llama.cpp 0.4.0 co Gemma, bez modułu obrazu. Model wykorzystuje niemal całe dostępne 16 GB, zachowując stabilność.
Gemma 4 12B — najlepszy wynik w tym porównaniu
Gemma 4 12B to multimodalny model Google na licencji Apache 2.0. Oficjalna karta opisuje obsługę tekstu, dźwięku, obrazu i wideo; tutaj wykorzystujemy wyłącznie część tekstową. Oficjalna karta Gemma 4 12B
W tym teście
Używamy Gemma w wersji Q6_K. Jej rozmiar pozwala zachować większą precyzję niż w Ministral Q5, a jednocześnie zmieścić się w pamięci karty. To również jedyny konkurent, który pomyślnie wykonał zaawansowane działanie.
Kwantyzacja jako zmienna dopasowania do sprzętu
Trzy modele nie są testowane z taką samą kwantyzacją: Q4_K_M dla Qwen, Q5_K_M dla Ministral i Q6_K dla Gemma. Wybór odpowiada konfiguracjom rzeczywiście użytecznym w My Wealth oraz sprzętowi, dla którego są przeznaczone.
| Model | Kwantyzacja | Maksymalne zaobserwowane użycie pamięci GPU |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Ten benchmark porównuje zatem konfiguracje produktu. Wyniki nie mają na celu wyizolowania samej architektury modeli.
Protokół testowy My Wealth
Pełny zestaw testowy My Wealth zawiera 354 pytania i działania. 15 z nich wybraliśmy przed rozpoczęciem jakichkolwiek pomiarów:
| Kategoria | Liczba | Zakres |
|---|---|---|
| Basic | 8 | Bezpośrednie zapytania o majątek |
| Intermediate | 2 | Zestawienie wielu danych |
| Advanced | 2 | Bardziej rozbudowana analiza i sekwencje narzędzi |
| Write | 2 | Proste działanie lub bezpieczna odmowa działania niemożliwego |
| Write Advanced | 1 | Pełne utworzenie obiektu z wieloma polami |
| Razem | 15 |
Każda konfiguracja obsługiwała dokładnie te same przypadki, najpierw w Vulkan, a potem w CUDA. Model pozostawał załadowany przez wszystkie piętnaście testów. Rozgrzewkę wyłączono z pomiarów, a syntetyczny majątek i rozmowę resetowano przed każdym przypadkiem. Uwzględniono tylko jedną mierzoną próbę; błąd modelu również pozostaje wynikiem.
Co mierzymy
1. Skuteczność funkcjonalna
Wszystkie 90 wyników sprawdziliśmy ręcznie. W przypadku zapytania oceniamy widoczną odpowiedź pod kątem poprawności i kompletności względem danych syntetycznych. Nadmiarowe wywołanie narzędzia nie zmienia dobrej odpowiedzi w porażkę. W przypadku zapisu sprawdzamy faktycznie zapisany efekt i każde wymagane pole: samo stwierdzenie powodzenia nie wystarcza.
2. Jakość odpowiedzi
Widoczne odpowiedzi analizujemy osobno pod kątem poprawności, przejrzystości, zgodności z danymi i użyteczności. Ta ręczna ocena wyznacza publikowany wynik.
3. Czas odpowiedzi
Całkowity czas obejmuje wybór narzędzi, planowanie, ich wywołania oraz odpowiedź końcową. Lepiej oddaje rzeczywisty czas oczekiwania niż sama szybkość generowania.
4. Vulkan kontra CUDA
Dla każdego modelu oba przebiegi używają tego samego pliku GGUF, szablonu, silnika i parametrów. Zmienia się tylko backend GPU.
Wyniki — jakość odpowiedzi
Wynik ogólny
| Konfiguracja | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, czyli 60% | 8/15, czyli 53% |
| Ministral 3 14B Q5_K_M | 11/15, czyli 73% | 11/15, czyli 73% |
| Gemma 4 12B Q6_K | 13/15, czyli 87% | 13/15, czyli 87% |
Zwycięzca pod względem jakości
Gemma 4 12B Q6_K osiąga najlepszy wynik w obu backendach: 13 sukcesów na 15. Ministral zajmuje drugie miejsce z wynikiem 11/15. Qwen uzyskuje 9/15 w Vulkan i 8/15 w CUDA.
Wyniki według kategorii
Oto konkretny przykład polecenia dla każdej kategorii:
| Kategoria | Przykład testowanego polecenia |
|---|---|
| Basic | „Jaka jest łączna kwota moich zobowiązań?” |
| Intermediate | „Porównaj wartość moich oszczędności z wartością moich długów.” |
| Advanced | „Tylko dla celu Spokojna emerytura: jaki jest jego obecny postęp i wymagany miesięczny wkład?” |
| Write | „Dodaj «Crédit Mutuel» do moich instytucji.” |
| Write Advanced | „Dodaj w Banque Horizon produkt «Compte Travaux» […] należący w 100% do Benoît Martin.” |
| Model i backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Wszystkie trzy modele nie zaliczają dwóch przypadków Write. Pierwszy wymagał dodania instytucji; żaden model nie doprowadził zmiany do końca. Drugi wymagał bezpośredniej modyfikacji wartości pochodnej od ceny złota: modele powinny były jasno wyjaśnić, że taki pojedynczy zapis nie jest obsługiwany, lecz ich przebiegi trwały aż do osiągnięcia limitów generowania lub narzędzi.
Kilka odpowiedzi, które nas zaskoczyły
Przykład 1 — znakomita odpowiedź zaawansowana
W pytaniu o cel „Spokojna emerytura” Ministral i Gemma odnajdują obie oczekiwane wartości. Ministral odpowiada między innymi:
„Obecny postęp: 29,67% […] Wymagany miesięczny wkład: 858,88 €.”
Odpowiedź jest krótka, konkretna i oparta na właściwej ścieżce odczytu danych.
Przykład 2 — odpowiedź wiarygodna… ale błędna
Qwen odpowiada, że udział aktywów finansowanych zobowiązaniami wynosi 13,70% w Vulkan i 15,94% w CUDA, podczas gdy oczekiwana wartość to 17,81%. Obliczenia wyglądają wiarygodnie, ale model pomija część zobowiązań lub wybiera niewłaściwy mianownik.
Ten błąd pokazuje, dlaczego przekonująca forma odpowiedzi finansowej nie wystarcza.
Przykład 3 — kiedy sposób użycia narzędzi robi różnicę
Na polecenie utworzenia produktu bankowego „Compte Travaux” Gemma poprawnie zapisuje wszystkie wymagane pola zarówno w Vulkan, jak i CUDA: instytucję, walutę, numer referencyjny, wpłatę, monitorowanie, właściciela i notatkę.
Ministral tworzy produkt, ale w rzeczywiście zapisanym efekcie pomija instytucję i notatkę, mimo że odpowiedź twierdzi co innego. Qwen nie wprowadza żadnej zmiany. Przykład ten pokazuje, dlaczego kontrola operacji zapisu musi dotyczyć zapisanego stanu, a nie tylko końcowego tekstu.
Wyniki — rzeczywista szybkość w My Wealth
Czas odpowiedzi
| Konfiguracja | Średnia | Mediana | Minimum | Maksimum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Zwycięzca pod względem szybkości
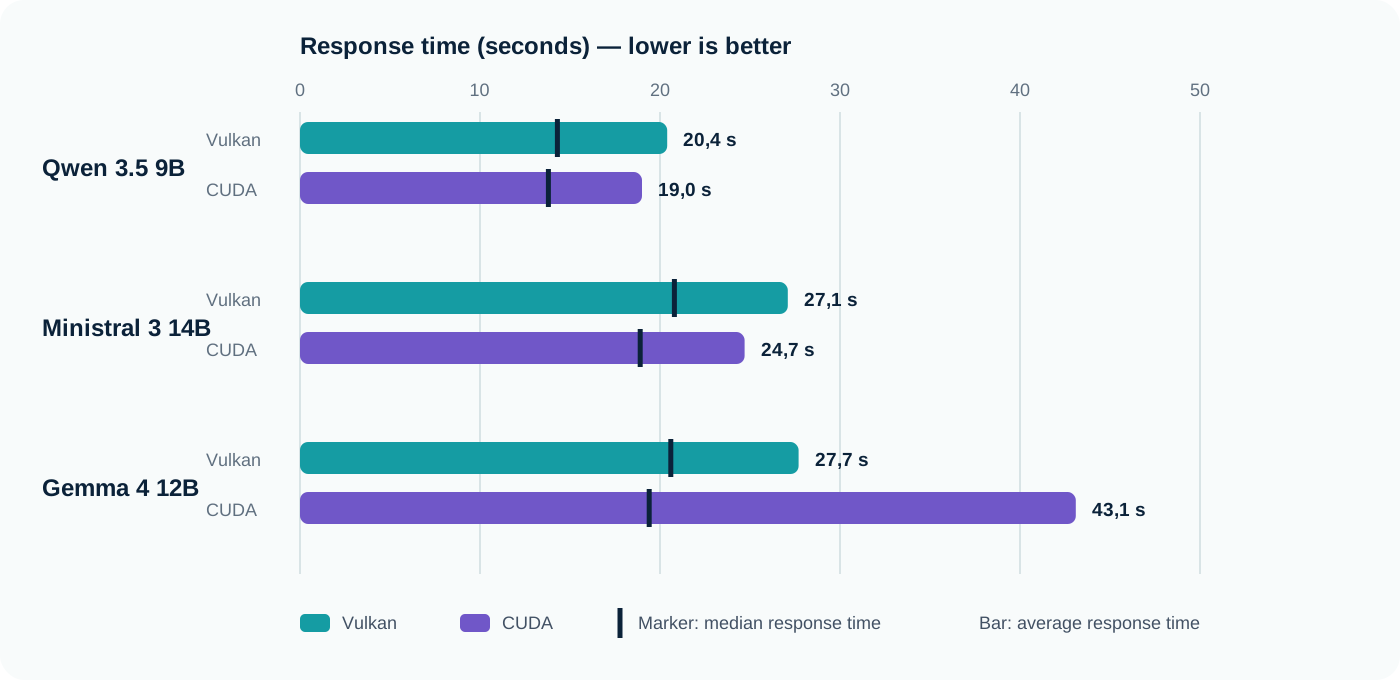
Qwen 3.5 9B w CUDA jest najszybszy zarówno pod względem średniej, jak i mediany. Wynik Gemma CUDA wymaga wyjaśnienia: mediana jest nieco lepsza niż w Vulkan, lecz w jednym przypadku model wygenerował 8192 tokeny podczas fazy planowania, która trwała 4 min 33 s. Ten incydent podnosi średnią do 43,1 s.
Vulkan kontra CUDA
Generowanie: tokeny na sekundę
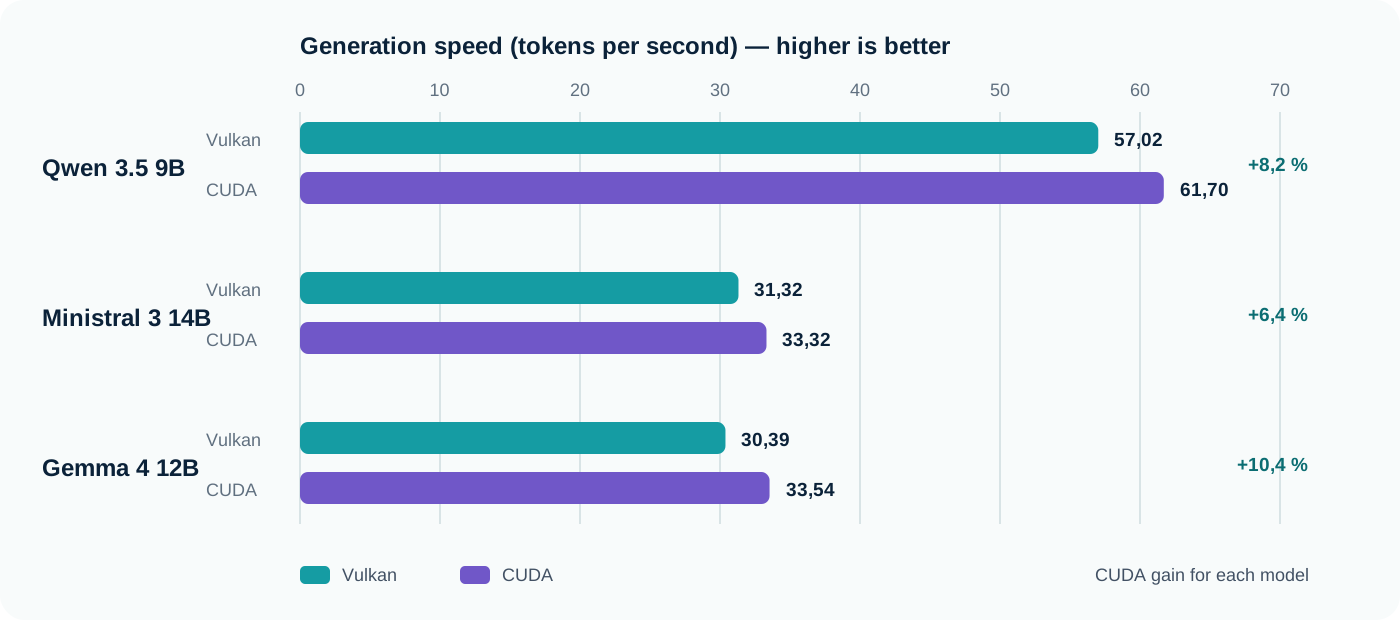
Przepustowość jest obliczana przez podzielenie łącznej liczby wygenerowanych tokenów przez całkowity czas generowania zmierzony przez llama.cpp. Nie jest to prosta średnia szybkości poszczególnych faz.
| Model | Vulkan | CUDA | Zysk CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok./s | 61,70 tok./s | +8,2% |
| Ministral 3 14B | 31,32 tok./s | 33,32 tok./s | +6,4% |
| Gemma 4 12B | 30,39 tok./s | 33,54 tok./s | +10,4% |
CUDA wygrywa pod względem surowej przepustowości we wszystkich trzech modelach. Nie gwarantuje to jednak lepszego czasu całkowitego: decyzje modelu i wywołania narzędzi często ważą więcej niż kilka dodatkowych tokenów na sekundę.
Średni czas odpowiedzi
CUDA skraca średni czas Qwen o około 7%, a Ministral o około 9%. W przypadku Gemma incydent podczas planowania zwiększa średnią o 56%, choć mediana spada o około 5%. Mediana lepiej opisuje tu typowe zachowanie; wartość maksymalna przypomina, że lokalny asystent może czasem rozpocząć bardzo długie generowanie.
Zwycięzcą nie zawsze jest najszybszy model
Qwen generuje niemal dwa razy więcej tokenów na sekundę niż pozostałe dwa modele, ale jego ocena ręczna jest wyraźnie niższa. Ministral zapewnia znaczną poprawę jakości bez nadmiernego wydłużania oczekiwania. Gemma uzyskuje najlepszy wynik i jako jedyna wykonuje zaawansowany zapis w obu backendach, kosztem niższej surowej szybkości i długiego incydentu w CUDA.
Nie obliczamy arbitralnego wyniku złożonego. Nie każde zastosowanie tak samo ceni zaoszczędzoną sekundę, poprawną odpowiedź czy prawidłowo wykonane działanie.
Który model wybrać?
Gdy priorytetem jest szybkość
Qwen 3.5 9B Q4_K_M w CUDA. Jest szybki i wymaga znacznie mniej pamięci, ale wynik 8/15 oznacza konieczność uważnej weryfikacji, gdy polecenie wykracza poza proste zapytanie.
Aby uzyskać najlepszą równowagę
Ministral 3 14B Q5_K_M w CUDA. Jego wynik pozostaje na poziomie 11/15 w obu backendach, a CUDA skraca medianę do 18,9 s. To solidny kompromis dla zapytań i analiz.
Gdy najważniejsza jest jakość
Gemma 4 12B Q6_K w Vulkan. Z wynikiem 13/15 i udanym działaniem zaawansowanym wygrywa to porównanie. Gemma uzyskuje taką samą ocenę w CUDA, ale Vulkan pozwala uniknąć incydentu planowania, który mocno wydłuża średnią w CUDA.
Podsumowanie
Na tej karcie RTX 5060 Ti 16 GB żaden model nie dominuje we wszystkich kryteriach.
Qwen jest mistrzem szybkości. Ministral oferuje najbardziej stabilny kompromis między czasem oczekiwania a jakością. Gemma w Vulkan zapewnia najlepsze wyniki funkcjonalne i wypada najbardziej przekonująco w złożonych zadaniach.
Wybór zależy więc od potrzeb: szybka odpowiedź na proste zapytania, równowaga dla codziennego asystenta albo maksymalny priorytet jakości i działań. W naszym porównaniu Gemma 4 12B Q6_K wygrywa pod względem jakości w obu backendach; preferujemy Vulkan za jego stabilność. Qwen 3.5 9B Q4_K_M w CUDA wygrywa pod względem szybkości.