
Qwen3.5-9B czy Ministral-3-14B-Instruct-2512: jak wiele naprawdę zmienia lokalny model AI?
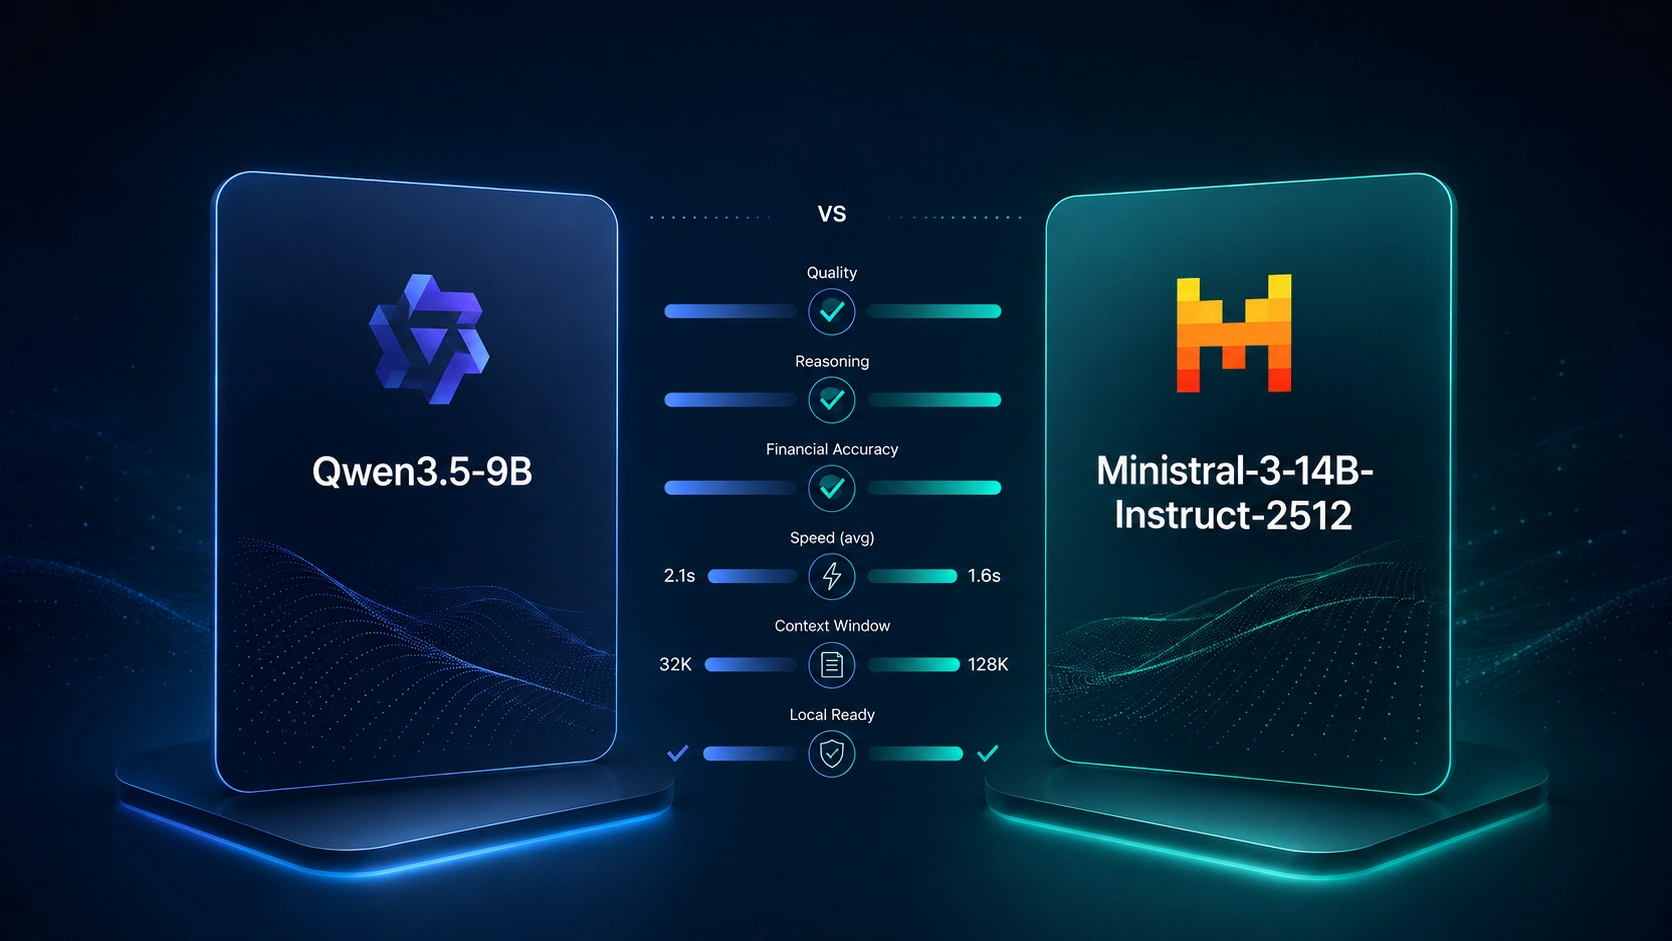
My Wealth 1.6 oferuje kilka lokalnych modeli AI dostosowanych do zasobów komputera. Qwen3.5-9B ma 9 miliardów parametrów, a Ministral-3-14B-Instruct-2512 — 14 miliardów.
Na papierze Ministral ma większe możliwości. Testy pokazują jednak ciekawszy obraz: większy model częściej radzi sobie ze złożonymi pytaniami, lecz nie zawsze jest lepszy. Lżejszy model może odpowiadać bardziej bezpośrednio, szybciej i czasem wierniej korzystać z dostarczonych danych strukturalnych.
Porównanie nie ma więc wyłonić bezwzględnego zwycięzcy. Pomaga zrozumieć sposób rozumowania modeli i ulepszać asystenta dla każdego profilu.
1. Jak oceniamy modele?
Używamy powtarzalnego portfela testowego oraz pytań sformułowanych tak, jak mogłyby zostać zadane w aplikacji. Scenariusze obejmują między innymi:
- wartość i skład majątku;
- podział i koncentrację;
- długi i finansowane nimi aktywa;
- dochód pasywny;
- budżety i operacje cykliczne;
- cele inwestycyjne i ich prognozy;
- żądania wymagające połączenia wielu źródeł;
- przygotowanie operacji modyfikacji z poszanowaniem uprawnień.
Model musi zrozumieć pytanie, wybrać właściwe narzędzia MCP, przygotować parametry, wykorzystać wyniki i stworzyć odpowiedź zgodną z danymi. Sprawdzamy również, czy nie wymyśla wartości ani nie proponuje niezamówionej operacji.
Błędy klasyfikujemy według pierwszej przyczyny: niewłaściwe narzędzie, wymyślony parametr, błędna wartość biznesowa, niewystarczająco uzasadniona odpowiedź albo problem wykonania. Poprawkę dodajemy tylko wtedy, gdy jej potrzebę potwierdzają ślady wykonania.
2. Wyniki w liczbach
Dla uczciwego porównania Qwen3.5-9B i Ministral-3-14B-Instruct-2512 otrzymały te same 46 pytań dotyczących identycznego portfela referencyjnego. Oba modele dysponowały również tymi samymi narzędziami do przeglądania i analizowania danych. Poniższe wyniki pochodzą z najnowszych dostępnych uruchomień każdego modelu:
| Wynik w 46 wspólnych scenariuszach | Qwen3.5-9B | Ministral-3-14B-Instruct-2512 |
|---|---|---|
| Testy zakończone sukcesem | 33 / 46 — 71,7% | 37 / 46 — 80,4% |
| Testy nieudane | 13 / 46 — 28,3% | 9 / 46 — 19,6% |
| Zaobserwowana mediana czasu | 2 min 52 s | 3 min 44 s |
To obraz etapu rozwoju, a nie uniwersalny benchmark. Testy przeprowadzono na komputerze z Intel Core Ultra 7 165U, zintegrowaną grafiką Intel i 18 GB pamięci współdzielonej, bez dedykowanej karty graficznej i własnej pamięci wideo. Mimo to Qwen odpowiada w ciągu kilku minut, a część typowych pytań obsługuje w niewiele ponad minutę.
Oba modele używały w praktyce części Compute układu graficznego Intel. Przy Ministral Vulkan może zgłaszać pozorne przejście na CPU, lecz monitoring pokazuje bezczynność procesora i obciążenie GPU. Testom towarzyszyły też kolejne ulepszenia orkiestratora, więc czasy nie izolują samej architektury modeli.
W tej kampanii Ministral przeszedł więcej scenariuszy, a Qwen pozostał zauważalnie szybszy.
Potwierdza to oczekiwany kompromis: większy model lepiej radzi sobie z niektórymi złożonymi pytaniami kosztem zasobów i zazwyczaj dłuższego czasu przetwarzania.
3. Gdzie Ministral ma przewagę
Ministral lepiej radził sobie, gdy odpowiedź wymagała połączenia wielu informacji. Lepiej zaliczył między innymi scenariusze dotyczące:
- porównania właścicieli;
- wartości rodziny aktywów zestawionej z poziomem długu;
- udziału dochodów generowanych przez aktywa finansowe;
- identyfikacji aktywów o dużej wartości, lecz niskiej rentowności;
- zestawienia finansowanych aktywów z powiązanymi zobowiązaniami;
- inwestycji cyklicznych skonfigurowanych w budżetach;
- celów najbardziej oddalonych od wartości docelowej.
Odpowiada to jego przeznaczeniu: bogatsze porównania, relacje między wieloma elementami i wieloetapowe pytania.
4. Gdzie Qwen zaskakuje
Qwen nie jest jedynie lżejszą alternatywą. Często odpowiada bardziej bezpośrednio, a jasnego podsumowania lub wyniku kanonicznego nie interpretuje ponownie bez potrzeby.
Niedawna seria obejmowała cztery domyślne pytania panelu AI:
- Jaka jest sytuacja mojego majątku?
- Gdzie mój majątek jest najbardziej skoncentrowany?
- Które aktywo osiąga najlepszy wynik?
- Jaką część majątku mogę szybko uruchomić?
Qwen odpowiedział poprawnie na wszystkie. Ministral zaliczył trzy w pierwszym pełnym przebiegu, ale pominął największą koncentrację mimo dostępności danych. Wybrał właściwą analizę MCP; błąd powstał podczas ponownej interpretacji zwróconych wymiarów.
Bardziej rozbudowane rozumowanie może rozwiązać złożone pytanie, ale również niepotrzebnie zmienić lub wzbogacić wynik, który był już obliczony.
5. Model nie pracuje sam
Jakość nie zależy wyłącznie od liczby parametrów LLM. My Wealth dodaje warstwę orkiestracji między pytaniem a danymi majątku.
Warstwa ta pełni kilka funkcji:
- przedstawia zwięzły katalog dostępnych narzędzi;
- pozostawia modelowi wybór przydatnych narzędzi i przygotowanie parametrów;
- sprawdza wywołania przed ich wykonaniem;
- zwraca błędy strukturalne, gdy plan można poprawić;
- oblicza niektóre relacje kanoniczne na podstawie wyników MCP;
- pozostawia modelowi odpowiedzialność za zrozumienie żądania i napisanie odpowiedzi.
Celem nie jest zastąpienie inteligencji modelu serią z góry ustalonych odpowiedzi, lecz zapewnienie mu niezawodnych ram: LLM interpretuje i wyjaśnia, a aplikacja zabezpiecza dostęp i stabilizuje dokładne fakty, które nie powinny zależeć od językowego przybliżenia.
Testy wykazały również, że oba modele nie zawsze korzystają z tych samych instrukcji. Wskazówka skuteczna dla Qwen może zostać zignorowana lub nadinterpretowana przez Ministral — i odwrotnie. My Wealth stosuje zatem zasady dopasowane do każdego modelu zamiast jednego uniwersalnego promptu.
6. Który profil wybrać?
Qwen jest najlepszym punktem wyjścia do codziennych pytań, podsumowań majątku i komputerów z ograniczonymi zasobami. Jego szybkość i bezpośredni sposób działania pozwalają już poprawnie odpowiadać na wiele użytecznych pytań.
Ministral przydaje się przy wielu wymiarach, porównywaniu elementów i analizach wymagających większej liczby etapów. Nie gwarantuje jednak idealnej odpowiedzi i może działać dłużej, szczególnie bez akceleracji GPU.
Wybór zależy od pytań, zasobów komputera i akceptowalnego czasu odpowiedzi.
7. Ocena trwa także po premierze
Wydanie My Wealth 1.6 nie kończy kampanii. Każdy powtarzalny błąd może ujawnić niejednoznaczne narzędzie, niejasną relację biznesową lub zachowanie konkretnego modelu.
Wnioski służą ulepszaniu orkiestratora, kontraktów MCP i reguł modeli bez ukrywania ich ograniczeń. Pomogą też wybierać przyszłe LLM, gdy zaoferują lepszy kompromis między jakością, szybkością i wymaganymi zasobami.
Jak każda sztuczna inteligencja, asystent może się pomylić. Ważne informacje finansowe należy zawsze weryfikować, niezależnie od profilu.