Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: comparație de LLM-uri locale pe RTX 5060 Ti
Modelele lingvistice de mici dimensiuni au progresat enorm. Acum este posibil să rulăm local, pe o placă grafică de larg consum, modele capabile să interogheze un patrimoniu, să coreleze mai multe date sau chiar să pregătească o acțiune într-o aplicație.
Dar o întrebare rămâne mai utilă decât orice clasament de benchmarkuri:
Întrebarea esențială: ce model funcționează cu adevărat cel mai bine într-o aplicație precum My Wealth?
Am comparat trei configurații oferite de profilurile AI din My Wealth:
| Profil My Wealth | Model | Cuantizare testată |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Viteza în tokeni pe secundă contează, însă prioritatea este obținerea unui răspuns exact, bazat pe datele portofoliului și produs cu instrumentele potrivite. Prin urmare, comparăm reușita funcțională, calitatea răspunsurilor, timpul necesar și performanțele cu Vulkan și CUDA.
Sistemul de testare
Toate modelele au fost rulate local pe același sistem.
Placa grafică
Placa NVIDIA GeForce RTX 5060 Ti de 16 GB face parte din generația Blackwell. Cei 16 GB de memorie GDDR7 permit păstrarea integrală pe GPU a celor trei modele cuantizate din această comparație. NVIDIA oferă placa în versiuni de 16 GB și 8 GB; am utilizat-o pe prima. Pagina oficială NVIDIA
Configurația completă
| Componentă | Configurație măsurată |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 nuclee și 12 fire de execuție |
| RAM | 31,9 GiB |
| Sistem | Windows 11 Pro, versiunea 26200 |
| Driver NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, versiunea 10809 |
| Context | 32.768 de tokeni |
| Backenduri | mai întâi Vulkan, apoi CUDA |
Modulul de imagistică al fiecărui model a fost dezactivat. Cele cincisprezece cazuri sunt exclusiv textuale, iar această setare evită ocuparea memoriei cu o componentă neutilizată. Memoria GPU maximă observată în timpul rulărilor a fost de aproximativ 7,7 GiB pentru Qwen, 15,8 GiB pentru Ministral și 12,0 GiB pentru Gemma.
Cele trei modele
Qwen 3.5 9B — modelul mic și foarte rapid
Qwen 3.5 9B este cel mai compact dintre cele trei. Depozitul oficial îl prezintă drept un model conversațional multimodal cu licență Apache 2.0. În testul nostru textual, dimensiunea redusă îi oferă un avantaj clar de viteză. Pagina oficială Qwen 3.5 9B
În acest test
Utilizăm Qwen în varianta Q4_K_M. Este configurația cea mai accesibilă și mai rapidă din comparație. Rezolvă bine cererile directe, dar devine mai puțin consecvent când orchestrarea sau scrierea se complică.
Ministral 3 14B Instruct 2512 — modelul edge de la Mistral AI
Ministral 3 14B este cel mai mare model testat. Mistral îl recomandă în special pentru implementări locale și edge; versiunea Instruct acceptă unsprezece limbi și folosește o licență Apache 2.0. Pagina oficială Ministral 3 14B Instruct
În acest test
Utilizăm Ministral în varianta Q5_K_M. Pentru a garanta o comparație Vulkan/CUDA simetrică și pentru a evita problema de memorie întâlnită cu vechiul său runtime, ambele rulări folosesc același motor llama.cpp 0.4.0 ca Gemma, fără modul de imagistică. Modelul ocupă aproape în întregime cei 16 GB disponibili, rămânând totuși stabil.
Gemma 4 12B — cel mai bun scor din comparație
Gemma 4 12B este un model multimodal Google cu licență Apache 2.0. Pagina sa oficială descrie intrări text, audio, imagine și video; aici folosim numai componenta textuală. Pagina oficială Gemma 4 12B
În acest test
Utilizăm Gemma în varianta Q6_K. Dimensiunea sa permite păstrarea unei precizii mai mari decât la Ministral Q5, fără a depăși capacitatea de memorie a plăcii. Este și singurul concurent care finalizează cu succes acțiunea avansată.
Cuantizarea ca variabilă de adaptare la hardware
Cele trei modele nu sunt testate cu aceeași cuantizare: Q4_K_M pentru Qwen, Q5_K_M pentru Ministral și Q6_K pentru Gemma. Alegerea corespunde profilurilor care pot fi folosite efectiv în My Wealth și hardware-ului vizat de acestea.
| Model | Cuantizare | Memorie GPU maximă observată |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Prin urmare, acest benchmark compară configurații de produs. Rezultatele nu pretind să izoleze exclusiv arhitectura modelelor.
Protocolul de testare My Wealth
Setul complet de testare My Wealth conține 354 de întrebări și acțiuni. Am selectat 15 înainte de orice măsurătoare:
| Categorie | Număr | Obiect |
|---|---|---|
| Basic | 8 | Consultări directe ale patrimoniului |
| Intermediate | 2 | Corelarea mai multor date |
| Advanced | 2 | Analize și parcursuri de instrumente mai elaborate |
| Write | 2 | Acțiune simplă sau refuz sigur al unei acțiuni imposibile |
| Write Advanced | 1 | Creare completă cu mai multe câmpuri |
| Total | 15 |
Fiecare configurație a procesat exact aceleași cazuri, mai întâi cu Vulkan și apoi cu CUDA. Modelul a rămas încărcat pe durata celor cincisprezece teste. O rulare de încălzire a fost exclusă din măsurători, iar patrimoniul sintetic și conversația au fost reinițializate pentru fiecare caz. A fost luată în considerare o singură încercare măsurată; o eroare a modelului rămâne un rezultat.
Ce măsurăm
1. Reușita funcțională
Cele 90 de rezultate au fost revizuite manual. Pentru o consultare, evaluăm exactitatea și caracterul complet al răspunsului vizibil în raport cu datele sintetice. Un apel redundant al unui instrument nu transformă un răspuns bun într-un eșec. Pentru o scriere, verificăm efectul înregistrat efectiv și fiecare câmp solicitat: simpla afirmare a succesului nu este suficientă.
2. Calitatea răspunsului
Revizuim separat răspunsurile vizibile: exactitate, claritate, fidelitate față de date și utilitate. Această evaluare umană determină scorul publicat.
3. Timpul de răspuns
Timpul total include selecția instrumentelor, planificarea, apelurile acestora și răspunsul final. Acesta reflectă mai bine așteptarea resimțită decât viteza de generare privită izolat.
4. Vulkan comparativ cu CUDA
Pentru fiecare model, cele două rulări utilizează același GGUF, același șablon, același motor și aceiași parametri. Se schimbă doar backendul GPU.
Rezultate — calitatea răspunsurilor
Rezultatul general
| Configurație | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, adică 60% | 8/15, adică 53% |
| Ministral 3 14B Q5_K_M | 11/15, adică 73% | 11/15, adică 73% |
| Gemma 4 12B Q6_K | 13/15, adică 87% | 13/15, adică 87% |
Câștigător la calitate
Gemma 4 12B Q6_K obține cel mai bun rezultat cu ambele backenduri, cu 13 reușite din 15. Ministral se clasează al doilea, cu 11/15. Qwen obține 9/15 cu Vulkan și 8/15 cu CUDA.
Rezultate pe categorii
Iată un exemplu concret de solicitare pentru fiecare categorie:
| Categorie | Exemplu de solicitare testată |
|---|---|
| Basic | „Care este valoarea totală a pasivelor mele?” |
| Intermediate | „Compară valoarea economiilor mele cu cea a datoriilor.” |
| Advanced | „Doar pentru obiectivul Pensie liniștită, care sunt progresul actual și efortul lunar necesar?” |
| Write | „Adaugă «Crédit Mutuel» la instituțiile mele.” |
| Write Advanced | „Adaugă la Banque Horizon un suport «Cont Lucrări» […] deținut în proporție de 100% de Benoît Martin.” |
| Model și backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Toate cele trei modele eșuează în cele două cazuri Write. Primul solicita adăugarea unei instituții; niciun model nu a finalizat modificarea. Al doilea solicita modificarea directă a unei valori derivate din cotația aurului: modelele ar fi trebuit să explice clar că această scriere izolată nu era acceptată, însă parcursurile lor au continuat până la atingerea limitelor de generare sau ale instrumentelor.
Câteva răspunsuri care ne-au surprins
Exemplul 1 — un răspuns avansat excelent
La întrebarea despre obiectivul „Pensie liniștită”, Ministral și Gemma găsesc cele două valori așteptate. Ministral răspunde astfel:
„Progres actual: 29,67% […] Efort lunar necesar: 858,88 €.”
Răspunsul este scurt, cuantificat și bazat pe parcursul corect de consultare.
Exemplul 2 — un răspuns plauzibil… dar greșit
Qwen răspunde că ponderea activelor finanțate din pasive este de 13,70% cu Vulkan și de 15,94% cu CUDA, deși valoarea așteptată este de 17,81%. Calculele par credibile, dar modelul omite o parte din pasive sau alege un numitor greșit.
Această eroare ilustrează de ce aspectul convingător al unui răspuns financiar nu este suficient.
Exemplul 3 — când utilizarea instrumentelor face diferența
La solicitarea de a crea suportul bancar „Cont Lucrări”, Gemma aplică exact toate câmpurile cerute atât cu Vulkan, cât și cu CUDA: instituție, monedă, referință, depunere, monitorizare, proprietar și notă.
Ministral creează un suport, dar omite instituția și nota din efectul înregistrat efectiv, în ciuda unui răspuns care susține contrariul. Qwen nu aplică nicio modificare. Acest exemplu arată de ce verificarea scrierilor trebuie să vizeze starea înregistrată, nu doar textul final.
Rezultate — viteza reală în My Wealth
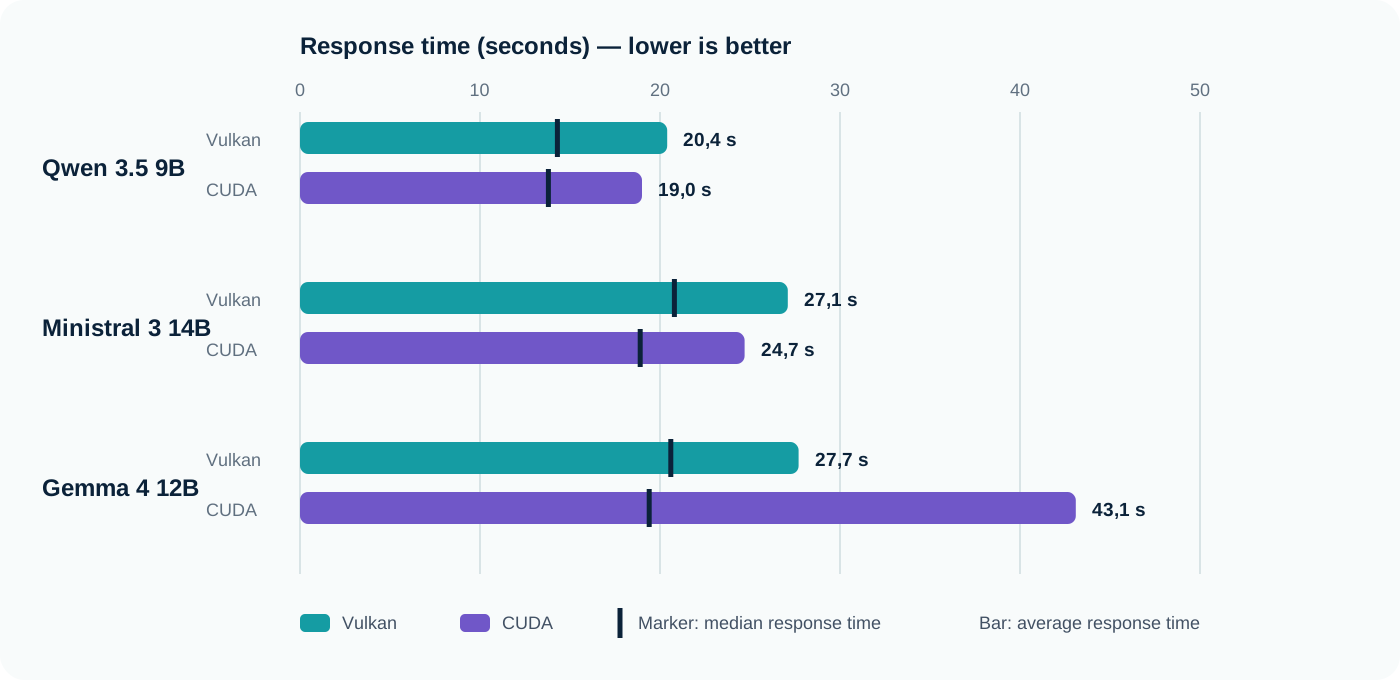
Timpul de răspuns
| Configurație | Medie | Mediană | Minim | Maxim |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Câștigător la viteză
Qwen 3.5 9B cu CUDA este cel mai rapid, atât ca medie, cât și ca mediană. Gemma CUDA necesită o explicație: mediana sa este puțin mai bună decât cu Vulkan, însă un caz a generat 8.192 de tokeni în timpul unei etape de planificare și a durat 4 min 33 s. Acest incident ridică media la 43,1 s.
Vulkan vs CUDA
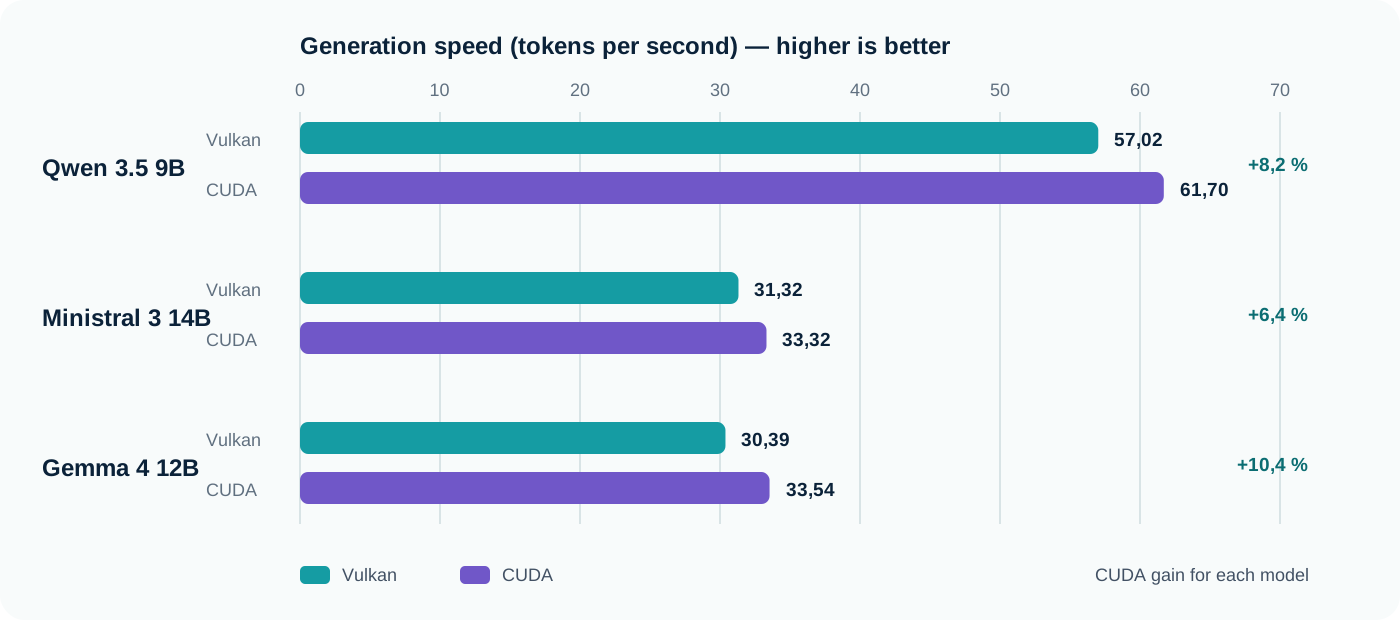
Generare: tokeni pe secundă
Viteza este agregată prin împărțirea numărului total de tokeni generați la durata totală de generare măsurată de llama.cpp. Nu este o medie simplă a vitezelor fiecărei etape.
| Model | Vulkan | CUDA | Câștig CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2% |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4% |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4% |
CUDA câștigă la viteza brută pentru toate cele trei modele. Totuși, acest lucru nu garantează un timp total mai bun: deciziile modelului și apelurile instrumentelor au adesea un impact mai mare decât câțiva tokeni pe secundă.
Timpul mediu de răspuns
CUDA reduce timpul mediu al Qwen cu aproximativ 7%, iar pe cel al Ministral cu aproximativ 9%. Pentru Gemma, incidentul de planificare mărește media cu 56%, în timp ce mediana scade cu aproximativ 5%. În acest caz, mediana descrie mai bine comportamentul obișnuit; valoarea maximă amintește că un asistent local poate porni ocazional într-o generare foarte lungă.
Câștigătorul nu este neapărat modelul cel mai rapid
Qwen produce aproape de două ori mai mulți tokeni pe secundă decât celelalte două modele, însă scorul său uman este net inferior. Ministral oferă un progres important în materie de calitate fără a prelungi excesiv așteptarea. Gemma obține cel mai bun scor și finalizează cu succes singura scriere avansată pe ambele backenduri, cu prețul unei viteze brute mai mici și al unui incident îndelungat cu CUDA.
Nu calculăm un scor compozit arbitrar. Nu toate utilizările acordă aceeași valoare unei secunde economisite, unui răspuns exact sau unei acțiuni executate corect.
Ce model să alegeți?
Pentru a acorda prioritate vitezei
Qwen 3.5 9B Q4_K_M cu CUDA. Este rapid și necesită mult mai puțină memorie, însă scorul de 8/15 impune o verificare atentă de îndată ce solicitarea depășește o consultare simplă.
Pentru a obține cel mai bun echilibru
Ministral 3 14B Q5_K_M cu CUDA. Scorul rămâne la 11/15 pe ambele backenduri, iar CUDA reduce mediana la 18,9 s. Este un compromis solid pentru întrebări de consultare și analiză.
Pentru a acorda prioritate absolută calității
Gemma 4 12B Q6_K cu Vulkan. Cu 13/15 și acțiunea avansată finalizată, câștigă această comparație. Gemma obține același scor cu CUDA, însă Vulkan evită incidentul de planificare care prelungește considerabil media CUDA.
Concluzie
Pe această placă RTX 5060 Ti de 16 GB, niciun model nu domină toate criteriile.
Qwen este campionul vitezei. Ministral oferă compromisul cel mai constant între așteptare și calitate. Gemma cu Vulkan oferă cele mai bune rezultate funcționale și este cel mai convingător pentru parcursurile complexe.
Alegerea depinde, așadar, de nevoie: răspuns rapid pentru consultări simple, echilibru pentru un asistent de zi cu zi sau prioritate maximă acordată calității și acțiunilor. În comparația noastră, Gemma 4 12B Q6_K câștigă la calitate cu ambele backenduri; preferăm Vulkan pentru consecvență. Qwen 3.5 9B Q4_K_M cu CUDA câștigă la viteză.