Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: test af lokale LLM’er på RTX 5060 Ti
Små sprogmodeller har gjort enorme fremskridt. Det er nu muligt lokalt på et grafikkort til forbrugere at køre modeller, som kan søge i en formue, sammenholde flere oplysninger eller forberede en handling i en applikation.
Men ét spørgsmål er mere nyttigt end en rangliste over benchmarkresultater:
Nøglespørgsmål: Hvilken model fungerer faktisk bedst i en applikation som My Wealth?
Vi har sammenlignet tre konfigurationer fra AI-profilerne i My Wealth:
| My Wealth-profil | Model | Testet kvantisering |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Antallet af tokens pr. sekund betyder noget, men det vigtigste er et korrekt svar, der bygger på porteføljens data og er udarbejdet med de rigtige værktøjer. Derfor sammenligner vi funktionel succes, svarkvalitet, tidsforbrug og ydeevne med Vulkan og CUDA.
Testmaskinen
Alle modeller blev kørt lokalt på den samme maskine.
Grafikkort
NVIDIA GeForce RTX 5060 Ti 16 GB tilhører Blackwell-generationen. Kortets 16 GB GDDR7 gør det muligt at have alle tre kvantiserede modeller i denne sammenligning fuldt indlæst i GPU’en. NVIDIA tilbyder kortet i udgaver med 16 GB og 8 GB; vi brugte den første. NVIDIAs officielle produktside
Komplet konfiguration
| Komponent | Målt konfiguration |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 kerner og 12 tråde |
| RAM | 31,9 GiB |
| System | Windows 11 Professional, build 26200 |
| NVIDIA-driver | 616.56 |
| Runtime | llama.cpp 0.4.0, build 10809 |
| Kontekst | 32.768 tokens |
| Backends | Først Vulkan, derefter CUDA |
Billedmodulet i hver model blev deaktiveret. De femten testtilfælde er udelukkende tekstbaserede, og indstillingen forhindrer en ubrugt komponent i at optage hukommelse. Det højeste observerede GPU-hukommelsesforbrug under kørslerne var cirka 7,7 GiB for Qwen, 15,8 GiB for Ministral og 12,0 GiB for Gemma.
De tre modeller
Qwen 3.5 9B — den meget hurtige lille model
Qwen 3.5 9B er den mest kompakte af de tre. Det officielle repository præsenterer den som en multimodal samtalemodel under Apache 2.0-licensen. I vores tekstbaserede test giver den mindre størrelse modellen et tydeligt forspring i hastighed. Officiel side for Qwen 3.5 9B
I denne test
Vi bruger Qwen i Q4_K_M. Det er den mest tilgængelige og hurtigste konfiguration i sammenligningen. Den klarer direkte forespørgsler godt, men bliver mindre stabil, så snart orkestreringen eller en skrivehandling bliver kompleks.
Ministral 3 14B Instruct 2512 — Mistral AI’s edge-model
Ministral 3 14B er den største model i testen. Mistral retter den blandt andet mod lokale installationer og edge-miljøer; Instruct-versionen understøtter elleve sprog og bruger Apache 2.0-licensen. Officiel side for Ministral 3 14B Instruct
I denne test
Vi bruger Ministral i Q5_K_M. For at sikre en symmetrisk sammenligning mellem Vulkan og CUDA og undgå det hukommelsesproblem, der blev konstateret med dens tidligere runtime, anvender begge kørsler den samme llama.cpp 0.4.0-motor som Gemma, uden billedmodul. Modellen bruger næsten alle de tilgængelige 16 GB, men forbliver stabil.
Gemma 4 12B — den højeste score i sammenligningen
Gemma 4 12B er en multimodal model fra Google under Apache 2.0-licensen. Den officielle side beskriver input i form af tekst, lyd, billeder og video; her bruger vi kun tekstdelen. Officiel side for Gemma 4 12B
I denne test
Vi bruger Gemma i Q6_K. Dens størrelse gør det muligt at bevare mere præcision end Ministral Q5 og samtidig holde sig inden for kortets hukommelsesramme. Det er også den eneste deltager, der gennemfører den avancerede handling.
Kvantisering som tilpasning til hardwaren
De tre modeller er ikke testet med den samme kvantisering: Q4_K_M for Qwen, Q5_K_M for Ministral og Q6_K for Gemma. Valget svarer til de profiler, der reelt kan bruges i My Wealth, og deres tilsigtede hardware.
| Model | Kvantisering | Højeste observerede GPU-hukommelse |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Denne benchmark sammenligner altså produktkonfigurationer. Resultaterne gør ikke krav på alene at isolere modellernes arkitektur.
My Wealths testprotokol
My Wealths komplette testbænk indeholder 354 spørgsmål og handlinger. Vi fastlagde 15 af dem før nogen måling:
| Kategori | Antal | Formål |
|---|---|---|
| Basic | 8 | Direkte opslag i formuen |
| Intermediate | 2 | Sammenholdelse af flere oplysninger |
| Advanced | 2 | Mere avanceret analyse og værktøjsforløb |
| Write | 2 | Enkel handling eller sikker afvisning af en umulig handling |
| Write Advanced | 1 | Komplet oprettelse med flere felter |
| I alt | 15 |
Hver konfiguration behandlede nøjagtig de samme tilfælde, først med Vulkan og derefter med CUDA. En model forblev indlæst under sine femten test. En opvarmningskørsel blev udeladt fra målingerne, og den syntetiske formue samt samtalen blev nulstillet for hvert tilfælde. Kun ét målt forsøg blev medtaget; en fejl fra modellen er stadig et resultat.
Det måler vi
1. Funktionel succes
Alle 90 resultater blev gennemgået manuelt. Ved et opslag vurderer vi det synlige svar ud fra dets korrekthed og fuldstændighed i forhold til de syntetiske data. Et overflødigt værktøjskald gør ikke et godt svar til en fiasko. Ved en skrivehandling kontrollerer vi den faktisk gemte effekt og hvert af de ønskede felter: Det er ikke nok blot at hævde, at handlingen lykkedes.
2. Svarkvalitet
Vi gennemgår de synlige svar særskilt: korrekthed, klarhed, trofasthed mod dataene og nytteværdi. Denne menneskelige gennemgang afgør den offentliggjorte score.
3. Svartid
Den samlede tid omfatter valg af værktøjer, planlægning, værktøjskald og det endelige svar. Den repræsenterer den oplevede ventetid bedre end en isoleret genereringshastighed.
4. Vulkan mod CUDA
For hver model bruger de to kørsler den samme GGUF-fil, den samme skabelon, den samme motor og de samme parametre. Kun GPU-backend ændres.
Resultater — svarenes kvalitet
Samlet resultat
| Konfiguration | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, svarende til 60 % | 8/15, svarende til 53 % |
| Ministral 3 14B Q5_K_M | 11/15, svarende til 73 % | 11/15, svarende til 73 % |
| Gemma 4 12B Q6_K | 13/15, svarende til 87 % | 13/15, svarende til 87 % |
Vinder på kvalitet
Gemma 4 12B Q6_K opnår det bedste resultat med begge backends: 13 vellykkede tilfælde ud af 15. Ministral bliver nummer to med 11/15. Qwen opnår 9/15 med Vulkan og 8/15 med CUDA.
Resultater efter kategori
Her er et konkret eksempel på en testet anmodning i hver kategori:
| Kategori | Eksempel på testet anmodning |
|---|---|
| Basic | »Hvad er det samlede beløb for mine forpligtelser?« |
| Intermediate | »Sammenlign værdien af min opsparing med værdien af min gæld.« |
| Advanced | »Hvad er den aktuelle fremgang og den nødvendige månedlige indsats alene for målet Tryg pension?« |
| Write | »Føj ‘Crédit Mutuel’ til mine institutter.« |
| Write Advanced | »Tilføj produktet ‘Compte Travaux’ hos Banque Horizon […] ejet 100 % af Benoît Martin.« |
| Model og backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Alle tre modeller fejler i de to Write-tilfælde. I det første skulle et institut tilføjes; ingen gennemførte ændringen. I det andet skulle en værdi afledt af guldprisen ændres direkte. Modellerne burde tydeligt have forklaret, at denne isolerede skrivehandling ikke blev understøttet, men deres forløb fortsatte, indtil grænsen for generering eller værktøjer blev nået.
Nogle svar, der overraskede os
Eksempel 1 — et fremragende avanceret svar
På spørgsmålet om målet »Tryg pension« finder Ministral og Gemma de to forventede værdier. Ministral svarer blandt andet:
»Aktuel fremgang: 29,67 % […] Nødvendig månedlig indsats: 858,88 €.«
Svaret er kort, talbaseret og bygger på det rigtige opslag.
Eksempel 2 — et plausibelt svar … der er forkert
Qwen svarer, at andelen af aktiver, der er finansieret af forpligtelser, er 13,70 % med Vulkan og 15,94 % med CUDA, mens den forventede værdi er 17,81 %. Beregningerne virker troværdige, men modellen udelader en del af forpligtelserne eller vælger en forkert nævner.
Fejlen viser, hvorfor en overbevisende formulering af et finansielt svar ikke er nok.
Eksempel 3 — når brugen af værktøjer gør forskellen
På anmodningen om at oprette bankproduktet »Compte Travaux« anvender Gemma nøjagtig alle de ønskede felter med både Vulkan og CUDA: institut, valuta, reference, indbetaling, opfølgning, ejer og note.
Ministral opretter et produkt, men udelader instituttet og noten i den faktisk gemte effekt, selv om svaret hævder det modsatte. Qwen foretager ingen ændring. Eksemplet viser, hvorfor skrivehandlinger skal vurderes ud fra den gemte tilstand og ikke kun den endelige tekst.
Resultater — reel hastighed i My Wealth
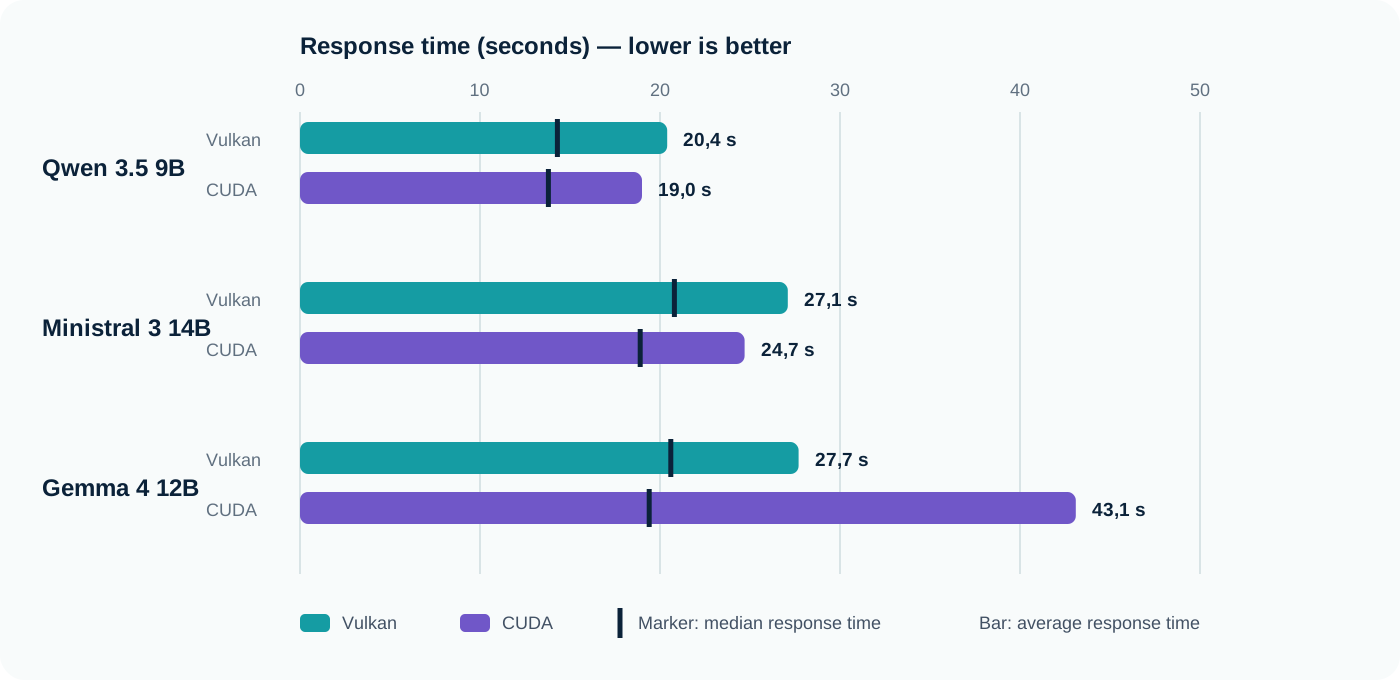
Svartid
| Konfiguration | Gennemsnit | Median | Minimum | Maksimum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vinder på hastighed
Qwen 3.5 9B med CUDA er hurtigst, både i gennemsnit og målt på medianen. Gemma CUDA kræver en forklaring: Medianen er en smule bedre end med Vulkan, men i ét tilfælde blev der genereret 8.192 tokens under en planlægningsfase, og processen tog 4 min. 33 sek. Denne hændelse hæver gennemsnittet til 43,1 s.
Vulkan vs CUDA
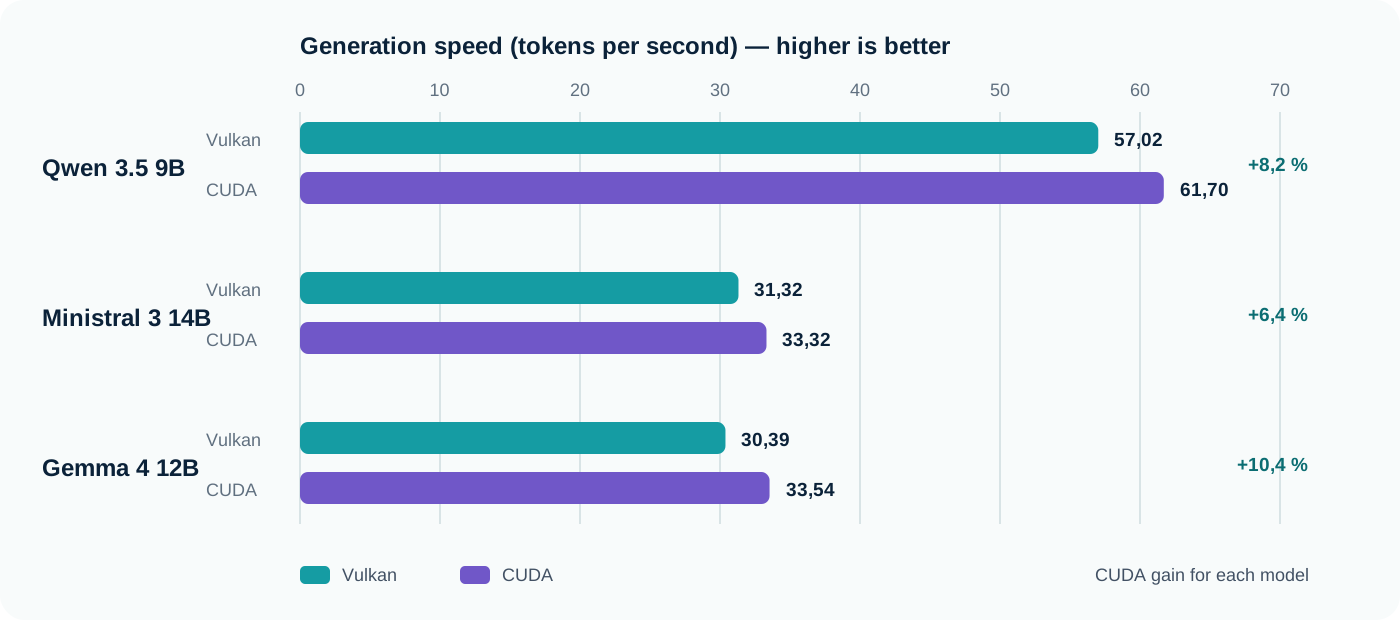
Generering: tokens pr. sekund
Hastigheden aggregeres ved at dividere det samlede antal genererede tokens med den samlede genereringstid målt af llama.cpp. Det er ikke et simpelt gennemsnit af hastigheden i hver fase.
| Model | Vulkan | CUDA | CUDA-gevinst |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA vinder på rå gennemstrømning for alle tre modeller. Det garanterer dog ikke en bedre samlet tid: Modellens beslutninger og værktøjskald vejer ofte tungere end nogle få tokens pr. sekund.
Gennemsnitlig svartid
CUDA reducerer Qwens gennemsnitlige tid med cirka 7 % og Ministrals med cirka 9 %. For Gemma øger planlægningshændelsen gennemsnittet med 56 %, mens medianen falder med cirka 5 %. Medianen beskriver her den normale adfærd bedre; maksimumværdien minder om, at en lokal assistent indimellem kan havne i en meget lang generering.
Vinderen er ikke nødvendigvis den hurtigste model
Qwen producerer næsten dobbelt så mange tokens pr. sekund som de to andre modeller, men dens menneskelige bedømmelse er markant lavere. Ministral giver en væsentlig forbedring af kvaliteten uden at forlænge ventetiden urimeligt. Gemma opnår den bedste score og gennemfører den eneste avancerede skrivehandling med begge backends, på bekostning af lavere rå hastighed og én langvarig hændelse med CUDA.
Vi beregner ikke en vilkårlig samlet score. Ikke alle anvendelser tillægger et sparet sekund, et korrekt svar eller en korrekt udført handling samme værdi.
Hvilken model skal du vælge?
Når hastighed har førsteprioritet
Qwen 3.5 9B Q4_K_M med CUDA. Den er hurtig og kræver betydeligt mindre hukommelse, men resultatet på 8/15 kræver omhyggelig kontrol, så snart anmodningen går videre end et enkelt opslag.
For den bedste balance
Ministral 3 14B Q5_K_M med CUDA. Scoren forbliver 11/15 med begge backends, og CUDA sænker medianen til 18,9 s. Det er et solidt kompromis til opslag og analysespørgsmål.
Når kvalitet frem for alt er vigtigst
Gemma 4 12B Q6_K med Vulkan. Med 13/15 og en vellykket avanceret handling vinder den sammenligningen. Gemma opnår samme score med CUDA, men Vulkan undgår den planlægningshændelse, der øger CUDA-gennemsnittet kraftigt.
Konklusion
På dette RTX 5060 Ti 16 GB dominerer ingen model alle kriterier.
Qwen er hastighedsmesteren. Ministral tilbyder det mest stabile kompromis mellem ventetid og kvalitet. Gemma med Vulkan giver de bedste funktionelle resultater og er mest overbevisende i komplekse forløb.
Valget afhænger derfor af behovet: hurtigt svar på enkle opslag, balance til en daglig assistent eller maksimal prioritet til kvalitet og handlinger. I vores sammenligning vinder Gemma 4 12B Q6_K på kvalitet med begge backends; vi foretrækker Vulkan på grund af stabiliteten. Qwen 3.5 9B Q4_K_M med CUDA vinder på hastighed.