Qwen 3.5 9B vs. Ministral 3 14B vs. Gemma 4 12B: Lokaler LLM-Benchmark auf einer RTX 5060 Ti
Kleine Sprachmodelle haben enorme Fortschritte gemacht. Heute können Modelle, die ein Vermögen abfragen, mehrere Datenpunkte abgleichen oder eine Aktion in einer Anwendung vorbereiten, lokal auf einer Grafikkarte für Endverbraucher ausgeführt werden.
Doch eine Frage ist nützlicher als jede Benchmark-Rangliste:
Kernfrage: Welches Modell funktioniert in einer Anwendung wie My Wealth tatsächlich am besten?
Wir haben drei Konfigurationen aus den KI-Profilen von My Wealth verglichen:
| My-Wealth-Profil | Modell | Getestete Quantisierung |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Tokens pro Sekunde sind relevant, entscheidend ist jedoch eine korrekte, auf den Vermögensdaten beruhende und mit den richtigen Werkzeugen erzeugte Antwort. Deshalb vergleichen wir funktionalen Erfolg, Antwortqualität, benötigte Zeit sowie die Leistung unter Vulkan und CUDA.
Der Testrechner
Alle Modelle liefen lokal auf demselben Rechner.
Grafikkarte
Die NVIDIA GeForce RTX 5060 Ti mit 16 GB gehört zur Blackwell-Generation. Ihre 16 GB GDDR7 reichen aus, um alle drei quantisierten Modelle dieses Vergleichs vollständig im GPU-Speicher zu halten. NVIDIA bietet die Karte mit 16 GB und 8 GB an; wir verwendeten die erste Variante. Offizielle NVIDIA-Seite
Vollständige Konfiguration
| Komponente | Gemessene Konfiguration |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 Kerne und 12 Threads |
| RAM | 31,9 GiB |
| System | Windows 11 Pro, Build 26200 |
| NVIDIA-Treiber | 616.56 |
| Laufzeit | llama.cpp 0.4.0, Build 10809 |
| Kontext | 32.768 Tokens |
| Backends | zuerst Vulkan, dann CUDA |
Das Bildmodul jedes Modells war deaktiviert. Die fünfzehn Fälle sind ausschließlich textbasiert; dadurch belegt eine ungenutzte Komponente keinen Speicher. Der beobachtete maximale GPU-Speicher betrug ungefähr 7,7 GiB für Qwen, 15,8 GiB für Ministral und 12,0 GiB für Gemma.
Die drei Modelle
Qwen 3.5 9B — das sehr schnelle kleine Modell
Qwen 3.5 9B ist das kompakteste der drei Modelle. Das offizielle Repository beschreibt es als multimodales Dialogmodell unter der Apache-2.0-Lizenz. Im reinen Texttest verschafft ihm seine geringere Größe einen deutlichen Geschwindigkeitsvorteil. Offizielle Seite von Qwen 3.5 9B
In diesem Test
Wir verwenden Qwen in Q4_K_M. Dies ist die zugänglichste und schnellste Konfiguration im Vergleich. Direkte Anfragen gelingen gut, bei komplexer Orchestrierung oder Schreibvorgängen wird das Modell jedoch weniger zuverlässig.
Ministral 3 14B Instruct 2512 — das Edge-Modell von Mistral AI
Ministral 3 14B ist das größte getestete Modell. Mistral richtet es insbesondere auf lokale und Edge-Bereitstellungen aus; die Instruct-Version unterstützt elf Sprachen und steht unter der Apache-2.0-Lizenz. Offizielle Seite von Ministral 3 14B Instruct
In diesem Test
Wir verwenden Ministral in Q5_K_M. Damit der Vulkan/CUDA-Vergleich symmetrisch bleibt und das Speicherproblem der früheren Laufzeit vermieden wird, nutzen beide Durchläufe dieselbe llama.cpp-0.4.0-Engine wie Gemma, ohne Bildmodul. Das Modell belegt fast die gesamten verfügbaren 16 GB und bleibt dabei stabil.
Gemma 4 12B — die höchste Wertung in diesem Vergleich
Gemma 4 12B ist ein multimodales Google-Modell unter der Apache-2.0-Lizenz. Die offizielle Seite beschreibt Text-, Audio-, Bild- und Videoeingaben; hier wird nur die Textkomponente genutzt. Offizielle Seite von Gemma 4 12B
In diesem Test
Wir verwenden Gemma in Q6_K. Die Größe bewahrt mehr Präzision als Ministral Q5 und passt dennoch in den Speicherrahmen der Karte. Gemma ist außerdem der einzige Kandidat, der die anspruchsvolle Aktion erfolgreich ausführt.
Quantisierung als Anpassung an die Hardware
Die drei Modelle werden nicht mit derselben Quantisierung getestet: Q4_K_M für Qwen, Q5_K_M für Ministral und Q6_K für Gemma. Diese Auswahl entspricht tatsächlich nutzbaren My-Wealth-Konfigurationen und ihren Hardwarezielen.
| Modell | Quantisierung | Maximal beobachteter GPU-Speicher |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Dieser Benchmark vergleicht somit Produktkonfigurationen. Die Ergebnisse sollen nicht allein die Modellarchitektur isolieren.
Das My-Wealth-Testprotokoll
Der vollständige My-Wealth-Prüfstand enthält 354 Fragen und Aktionen. 15 davon wurden vor jeder Messung festgelegt:
| Kategorie | Anzahl | Zweck |
|---|---|---|
| Basic | 8 | Direkte Abfragen des Vermögens |
| Intermediate | 2 | Abgleich mehrerer Datenpunkte |
| Advanced | 2 | Anspruchsvollere Analysen und Werkzeugpfade |
| Write | 2 | Einfache Aktion oder sichere Ablehnung einer unmöglichen Aktion |
| Write Advanced | 1 | Vollständige Erstellung mit mehreren Feldern |
| Gesamt | 15 |
Jede Konfiguration bearbeitete exakt dieselben Fälle, zuerst unter Vulkan und danach unter CUDA. Ein Modell blieb während seiner fünfzehn Tests geladen. Ein Aufwärmlauf wurde nicht gemessen; das synthetische Vermögen und die Unterhaltung wurden für jeden Fall zurückgesetzt. Es zählt jeweils nur ein gemessener Versuch, und ein Modellfehler bleibt ein Ergebnis.
Was wir messen
1. Funktionaler Erfolg
Alle 90 Ergebnisse wurden manuell geprüft. Bei einer Abfrage bewerten wir die sichtbare Antwort anhand ihrer Richtigkeit und Vollständigkeit gegenüber den synthetischen Daten. Ein überflüssiger Werkzeugaufruf macht eine korrekte Antwort nicht zum Fehler. Bei Schreibvorgängen prüfen wir die tatsächlich gespeicherte Wirkung und jedes angeforderte Feld: Eine bloße Erfolgsmeldung genügt nicht.
2. Antwortqualität
Die sichtbaren Antworten werden getrennt nach Richtigkeit, Klarheit, Datentreue und Nutzen beurteilt. Diese menschliche Prüfung bestimmt die veröffentlichte Wertung.
3. Antwortzeit
Die Gesamtzeit umfasst Werkzeugauswahl, Planung, Werkzeugaufrufe und die abschließende Antwort. Sie bildet die tatsächliche Wartezeit besser ab als der reine Generierungsdurchsatz.
4. Vulkan gegen CUDA
Für jedes Modell verwenden beide Durchläufe dasselbe GGUF, dieselbe Vorlage, dieselbe Engine und dieselben Parameter. Nur das GPU-Backend ändert sich.
Ergebnisse — Antwortqualität
Gesamtergebnis
| Konfiguration | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, also 60 % | 8/15, also 53 % |
| Ministral 3 14B Q5_K_M | 11/15, also 73 % | 11/15, also 73 % |
| Gemma 4 12B Q6_K | 13/15, also 87 % | 13/15, also 87 % |
Qualitätssieger
Gemma 4 12B Q6_K erzielt unter beiden Backends mit 13 von 15 Erfolgen das beste Ergebnis. Ministral folgt mit 11/15. Qwen erreicht 9/15 unter Vulkan und 8/15 unter CUDA.
Ergebnisse nach Kategorie
Hier ein konkretes Beispiel aus jeder Kategorie:
| Kategorie | Beispiel einer getesteten Anfrage |
|---|---|
| Basic | „Wie hoch sind meine gesamten Verbindlichkeiten?“ |
| Intermediate | „Vergleiche den Wert meiner Ersparnisse mit meinen Schulden.“ |
| Advanced | „Wie hoch sind beim Ziel Retraite sereine der aktuelle Fortschritt und der erforderliche monatliche Beitrag?“ |
| Write | „Füge Crédit Mutuel zu meinen Instituten hinzu.“ |
| Write Advanced | „Lege bei Banque Horizon ein Konto Compte Travaux […] an, das zu 100 % Benoît Martin gehört.“ |
| Modell und Backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Alle drei Modelle scheitern an beiden Write-Fällen. Im ersten sollte ein Institut hinzugefügt werden; keines führte die Änderung zu Ende. Im zweiten sollte ein direkt vom Goldpreis abgeleiteter Wert verändert werden. Die Modelle hätten klar erklären müssen, dass dieser isolierte Schreibvorgang nicht unterstützt wird, liefen aber bis an die Grenzen von Generierung oder Werkzeugnutzung weiter.
Einige Antworten, die uns überrascht haben
Beispiel 1 — eine ausgezeichnete anspruchsvolle Antwort
Bei der Frage zum Ziel „Retraite sereine“ finden Ministral und Gemma beide erwarteten Werte. Ministral antwortet unter anderem:
„Aktueller Fortschritt: 29,67 % […] Erforderlicher monatlicher Beitrag: 858,88 €.“
Die Antwort ist kurz, beziffert und beruht auf dem richtigen Abfragepfad.
Beispiel 2 — eine plausible, aber falsche Antwort
Qwen antwortet, dass die Verbindlichkeiten unter Vulkan 13,70 % und unter CUDA 15,94 % der Vermögenswerte finanzieren, obwohl 17,81 % erwartet werden. Die Berechnungen wirken glaubwürdig, doch das Modell lässt einen Teil der Verbindlichkeiten aus oder wählt den falschen Nenner.
Dieser Fehler zeigt, warum eine überzeugend formulierte Finanzantwort allein nicht genügt.
Beispiel 3 — wenn die Werkzeugnutzung den Unterschied macht
Beim Auftrag, das Bankkonto „Compte Travaux“ anzulegen, setzt Gemma unter Vulkan wie CUDA alle angeforderten Felder exakt um: Institut, Währung, Referenz, Einzahlung, Nachverfolgung, Eigentümer und Notiz.
Ministral legt zwar ein Konto an, lässt aber Institut und Notiz in der tatsächlich gespeicherten Wirkung aus, obwohl die Antwort das Gegenteil behauptet. Qwen führt keine Änderung aus. Deshalb müssen Schreibvorgänge am gespeicherten Zustand und nicht nur am Abschlusstext geprüft werden.
Ergebnisse — reale Geschwindigkeit in My Wealth
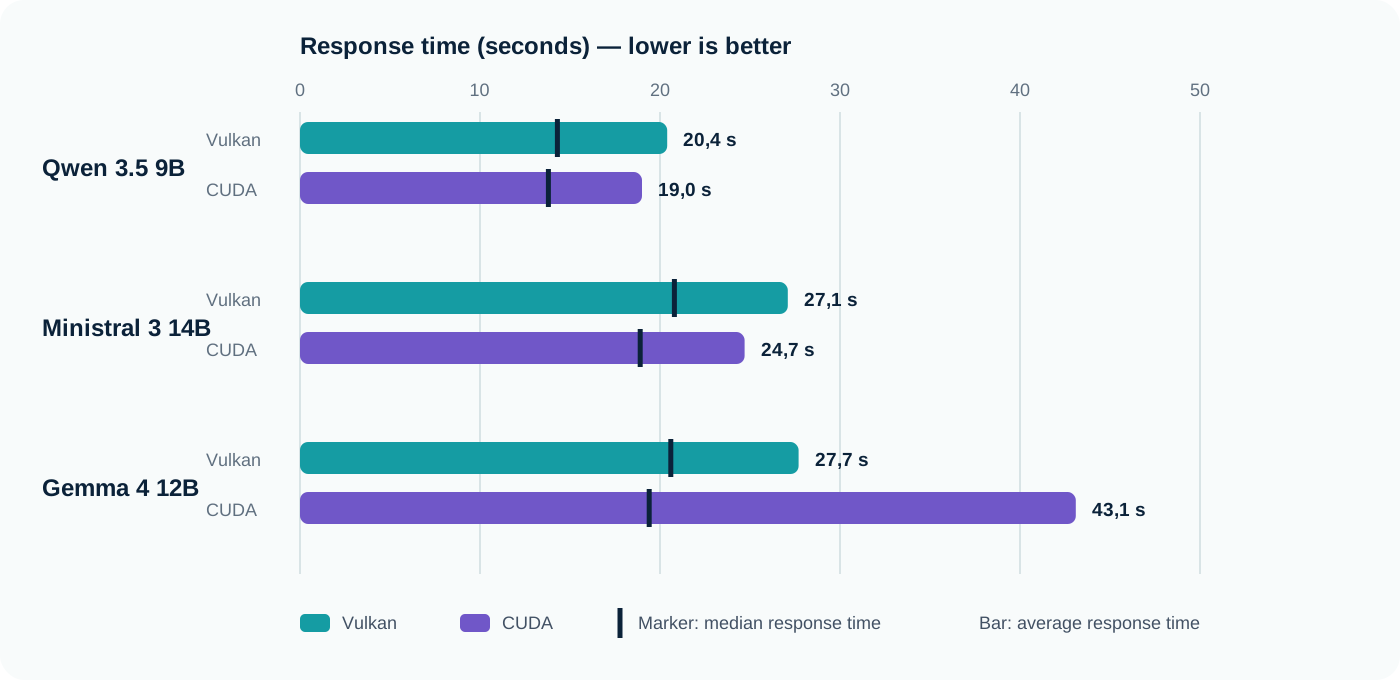
Antwortzeiten
| Konfiguration | Mittelwert | Median | Minimum | Maximum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Geschwindigkeitssieger
Qwen 3.5 9B unter CUDA ist sowohl im Mittel als auch beim Median am schnellsten. Gemma CUDA braucht eine Einordnung: Sein Median ist etwas besser als unter Vulkan, doch ein Fall erzeugte während der Planung 8.192 Tokens und dauerte 4 Minuten 33 Sekunden. Dadurch steigt der Mittelwert auf 43,1 Sekunden.
Vulkan vs. CUDA
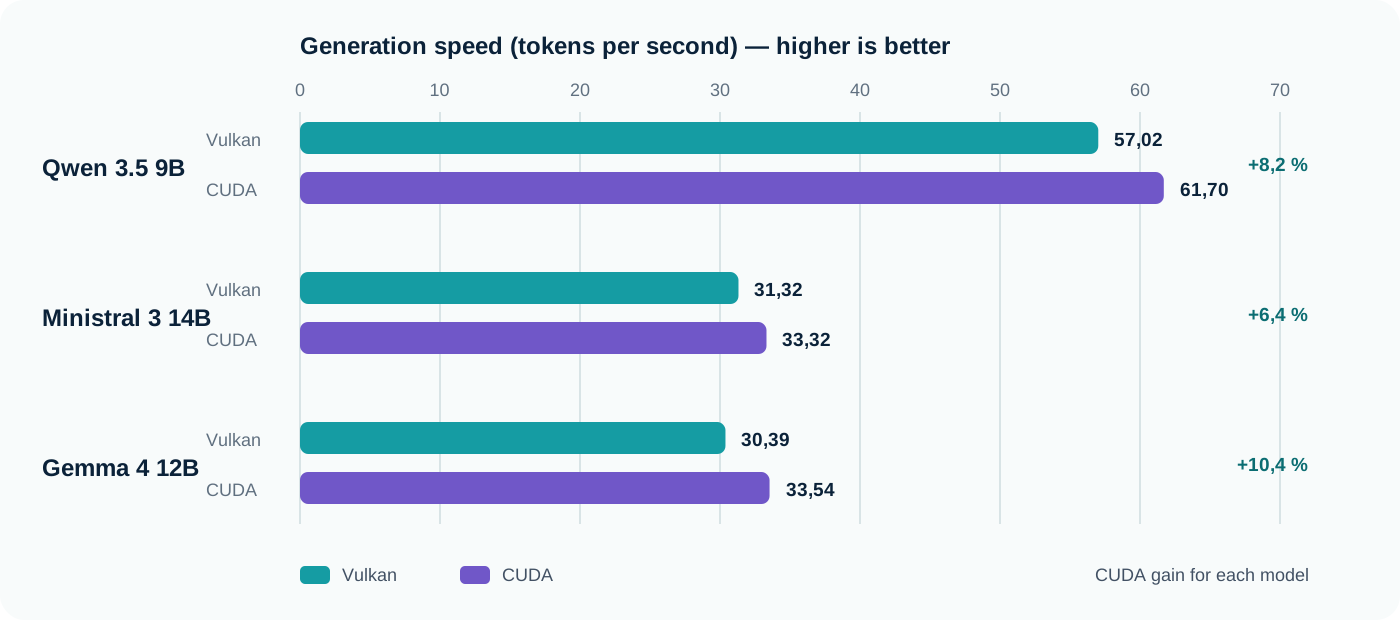
Generierung: Tokens pro Sekunde
Der Durchsatz ergibt sich aus der Gesamtzahl erzeugter Tokens geteilt durch die von llama.cpp gemessene gesamte Generierungsdauer. Es handelt sich nicht um den einfachen Mittelwert der einzelnen Phasen.
| Modell | Vulkan | CUDA | CUDA-Gewinn |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA gewinnt beim Rohdurchsatz für alle drei Modelle. Eine kürzere Gesamtzeit ist damit jedoch nicht garantiert: Modellentscheidungen und Werkzeugaufrufe wiegen oft schwerer als einige Tokens pro Sekunde.
Mittlere Antwortzeit
CUDA senkt Qwens Mittelwert um etwa 7 % und den von Ministral um etwa 9 %. Bei Gemma erhöht der Planungsvorfall den Mittelwert um 56 %, während der Median um ungefähr 5 % sinkt. Der Median beschreibt hier das typische Verhalten besser; das Maximum erinnert daran, dass ein lokaler Assistent gelegentlich sehr lange generieren kann.
Der Sieger ist nicht unbedingt das schnellste Modell
Qwen erzeugt fast doppelt so viele Tokens pro Sekunde wie die beiden anderen Modelle, wird von Menschen jedoch deutlich schlechter bewertet. Ministral verbessert die Qualität erheblich, ohne die Wartezeit übermäßig zu verlängern. Gemma erzielt die beste Wertung und führt den einzigen anspruchsvollen Schreibvorgang unter beiden Backends aus, ist dafür im Rohdurchsatz langsamer und hatte unter CUDA einen langen Ausreißer.
Wir berechnen keinen willkürlichen Gesamtwert. Je nach Nutzung sind eine gesparte Sekunde, eine korrekte Antwort oder eine richtig ausgeführte Aktion unterschiedlich wichtig.
Welches Modell wählen?
Wenn Geschwindigkeit Vorrang hat
Qwen 3.5 9B Q4_K_M unter CUDA. Es ist schnell und benötigt deutlich weniger Speicher, doch bei einer Wertung von 8/15 sollten Anfragen jenseits einfacher Abfragen sorgfältig geprüft werden.
Für das beste Gleichgewicht
Ministral 3 14B Q5_K_M unter CUDA. Die Wertung bleibt unter beiden Backends bei 11/15, während CUDA den Median auf 18,9 Sekunden senkt. Für Abfragen und Analysen ist dies ein solider Kompromiss.
Wenn Qualität oberste Priorität hat
Gemma 4 12B Q6_K unter Vulkan. Mit 13/15 und einer erfolgreichen anspruchsvollen Aktion gewinnt es diesen Vergleich. Unter CUDA erreicht Gemma dieselbe Wertung, doch Vulkan vermeidet den Planungsvorfall, der den CUDA-Mittelwert stark erhöht.
Fazit
Auf dieser RTX 5060 Ti mit 16 GB dominiert kein Modell alle Kriterien.
Qwen ist der Geschwindigkeitsmeister. Ministral bietet das beständigste Verhältnis zwischen Wartezeit und Qualität. Gemma unter Vulkan liefert die besten funktionalen Ergebnisse und überzeugt bei komplexen Abläufen am meisten.
Die Wahl hängt daher vom Bedarf ab: schnelle Antworten auf einfache Abfragen, Ausgewogenheit für einen täglichen Assistenten oder höchste Priorität für Qualität und Aktionen. In unserem Vergleich gewinnt Gemma 4 12B Q6_K mit beiden Backends bei der Qualität; wegen seiner Beständigkeit bevorzugen wir Vulkan. Qwen 3.5 9B Q4_K_M unter CUDA gewinnt bei der Geschwindigkeit.