Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B : benchmark LLM local sur RTX 5060 Ti
Les petits modèles de langage ont énormément progressé. Il est désormais possible d’exécuter localement, sur une carte graphique grand public, des modèles capables d’interroger un patrimoine, de rapprocher plusieurs données ou encore de préparer une action dans une application.
Mais une question reste plus utile qu’un classement de benchmarks :
Question clé : quel modèle fonctionne réellement le mieux dans une application comme My Wealth ?
Nous avons confronté trois configurations proposées par les profils IA de My Wealth :
| Profil My Wealth | Modèle | Quantification testée |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Le débit en tokens par seconde compte, mais la priorité est d’obtenir une réponse exacte, fondée sur les données du portefeuille et produite avec les bons outils. Nous comparons donc la réussite fonctionnelle, la qualité des réponses, le temps nécessaire et les performances sous Vulkan et CUDA.
La machine de test
Tous les modèles ont été exécutés localement sur la même machine.
Carte graphique
La NVIDIA GeForce RTX 5060 Ti 16 Go appartient à la génération Blackwell. Ses 16 Go de GDDR7 permettent de conserver intégralement sur le GPU les trois modèles quantifiés de ce comparatif. NVIDIA propose cette carte en versions 16 Go et 8 Go ; nous avons utilisé la première. Fiche officielle NVIDIA
Configuration complète
| Composant | Configuration mesurée |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 Mio |
| CPU | AMD Ryzen 5 2600, 6 cœurs et 12 threads |
| RAM | 31,9 Gio |
| Système | Windows 11 Professionnel, build 26200 |
| Pilote NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, build 10809 |
| Contexte | 32 768 tokens |
| Backends | Vulkan puis CUDA |
Le module d’imagerie de chaque modèle a été désactivé. Les quinze cas sont exclusivement textuels et ce réglage évite d’occuper de la mémoire pour un composant inutilisé. Le maximum de mémoire GPU observé pendant les passages a été d’environ 7,7 Gio pour Qwen, 15,8 Gio pour Ministral et 12,0 Gio pour Gemma.
Les trois modèles
Qwen 3.5 9B — le petit modèle très rapide
Qwen 3.5 9B est le plus compact des trois. Le dépôt officiel le présente comme un modèle conversationnel multimodal sous licence Apache 2.0. Dans notre essai textuel, son poids réduit lui donne une nette avance en vitesse. Fiche officielle Qwen 3.5 9B
Dans ce test
Nous utilisons Qwen en Q4_K_M. C’est la configuration la plus accessible et la plus rapide du comparatif. Elle réussit bien les demandes directes, mais se montre moins régulière dès que l’orchestration ou l’écriture devient complexe.
Ministral 3 14B Instruct 2512 — le modèle edge de Mistral AI
Ministral 3 14B est le plus grand modèle testé. Mistral le destine notamment aux déploiements locaux et edge ; sa version Instruct prend en charge onze langues et utilise une licence Apache 2.0. Fiche officielle Ministral 3 14B Instruct
Dans ce test
Nous utilisons Ministral en Q5_K_M. Pour garantir une comparaison Vulkan/CUDA symétrique et éviter le problème de mémoire constaté avec son ancien runtime, les deux passages emploient le même moteur llama.cpp 0.4.0 que Gemma, sans module d’imagerie. Le modèle occupe presque entièrement les 16 Go disponibles, tout en restant stable.
Gemma 4 12B — le meilleur score de ce comparatif
Gemma 4 12B est un modèle multimodal de Google sous licence Apache 2.0. Sa fiche officielle décrit des entrées texte, audio, image et vidéo ; seule sa partie textuelle est utilisée ici. Fiche officielle Gemma 4 12B
Dans ce test
Nous utilisons Gemma en Q6_K. Sa taille permet de conserver davantage de précision que le Ministral Q5 tout en restant dans l’enveloppe mémoire de la carte. C’est aussi le seul concurrent à réussir l’action avancée.
La quantification comme variable d’ajustement matériel
Les trois modèles ne sont pas testés avec la même quantification : Q4_K_M pour Qwen, Q5_K_M pour Ministral et Q6_K pour Gemma. Ce choix correspond aux profils réellement utilisables dans My Wealth et à leur cible matérielle.
| Modèle | Quantification | Mémoire GPU maximale observée |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 Gio |
| Ministral 3 14B | Q5_K_M | 15,8 Gio |
| Gemma 4 12B | Q6_K | 12,0 Gio |
Ce benchmark compare donc des configurations de produit. Les résultats ne prétendent pas isoler la seule architecture des modèles.
Le protocole de test My Wealth
Le banc complet de My Wealth contient 354 questions et actions. Nous en avons figé 15 avant toute mesure :
| Catégorie | Nombre | Objet |
|---|---|---|
| Basic | 8 | Consultations directes du patrimoine |
| Intermediate | 2 | Rapprochement de plusieurs données |
| Advanced | 2 | Analyse et parcours d’outils plus élaborés |
| Write | 2 | Action simple ou refus sûr d’une action impossible |
| Write Advanced | 1 | Création complète avec plusieurs champs |
| Total | 15 |
Chaque configuration a traité exactement les mêmes cas, d’abord sous Vulkan puis sous CUDA. Un modèle restait chargé pendant ses quinze tests. Une chauffe était exclue des mesures et le patrimoine synthétique ainsi que la conversation étaient réinitialisés pour chaque cas. Une seule tentative mesurée a été retenue ; une erreur du modèle reste un résultat.
Ce que nous mesurons
1. Réussite fonctionnelle
Les 90 résultats ont été relus manuellement. Pour une consultation, nous jugeons la réponse visible sur son exactitude et sa complétude par rapport aux données synthétiques. Un appel d’outil redondant ne transforme pas une bonne réponse en échec. Pour une écriture, nous vérifions l’effet réellement enregistré et chacun des champs demandés : une simple affirmation de succès ne suffit pas.
2. Qualité de la réponse
Nous relisons séparément les réponses visibles : exactitude, clarté, fidélité aux données et utilité. Cette revue humaine détermine la note publiée.
3. Temps de réponse
Le temps total inclut la sélection des outils, la planification, leurs appels et la réponse finale. Il représente mieux l’attente vécue qu’un débit de génération pris isolément.
4. Vulkan contre CUDA
Pour chaque modèle, les deux passages utilisent le même GGUF, le même template, le même moteur et les mêmes paramètres. Seul le backend GPU change.
Résultats — qualité des réponses
Résultat global
| Configuration | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, soit 60 % | 8/15, soit 53 % |
| Ministral 3 14B Q5_K_M | 11/15, soit 73 % | 11/15, soit 73 % |
| Gemma 4 12B Q6_K | 13/15, soit 87 % | 13/15, soit 87 % |
Vainqueur qualité
Gemma 4 12B Q6_K obtient le meilleur résultat sous les deux backends, avec 13 réussites sur 15. Ministral arrive deuxième avec 11/15. Qwen obtient 9/15 sous Vulkan et 8/15 sous CUDA.
Résultats par catégorie
Voici un exemple concret de demande pour chaque catégorie :
| Catégorie | Exemple de demande testée |
|---|---|
| Basic | « Quel est le montant total de mes passifs ? » |
| Intermediate | « Compare la valeur de mon épargne à celle de mes dettes. » |
| Advanced | « Pour le seul objectif Retraite sereine, quelle est sa progression actuelle et son effort mensuel requis ? » |
| Write | « Ajoute “Crédit Mutuel” à mes établissements. » |
| Write Advanced | « Ajoute chez Banque Horizon un support “Compte Travaux” […] détenu à 100 % par Benoît Martin. » |
| Modèle et backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Les trois modèles échouent aux deux cas Write. Le premier demandait d’ajouter un établissement ; aucun n’a mené la mutation à terme. Le second demandait de modifier directement une valeur dérivée du cours de l’or : les modèles auraient dû expliquer clairement que cette écriture isolée n’était pas prise en charge, mais leurs parcours se sont prolongés jusqu’aux limites de génération ou d’outils.
Quelques réponses qui nous ont surpris
Exemple 1 — une excellente réponse avancée
À la question sur l’objectif « Retraite sereine », Ministral et Gemma retrouvent les deux valeurs attendues. Ministral répond notamment :
« Progression actuelle : 29,67 % […] Effort mensuel requis : 858,88 €. »
La réponse est courte, chiffrée et fondée sur le bon parcours de consultation.
Exemple 2 — une réponse plausible… mais fausse
Qwen répond que la part des actifs financée par les passifs est de 13,70 % sous Vulkan et 15,94 % sous CUDA, alors que la valeur attendue est 17,81 %. Les calculs semblent crédibles, mais le modèle omet une partie des passifs ou choisit un mauvais dénominateur.
Cette erreur illustre pourquoi la forme convaincante d’une réponse financière ne suffit pas.
Exemple 3 — quand l’utilisation des outils fait la différence
À la demande de créer le support bancaire « Compte Travaux », Gemma applique exactement tous les champs demandés sous Vulkan comme sous CUDA : établissement, devise, référence, versement, suivi, propriétaire et note.
Ministral crée bien un support, mais omet l’établissement et la note dans l’effet réellement enregistré, malgré une réponse qui affirme le contraire. Qwen n’applique aucune mutation. Cet exemple montre pourquoi la relecture des écritures doit porter sur l’état enregistré, pas uniquement sur le texte final.
Résultats — vitesse réelle dans My Wealth
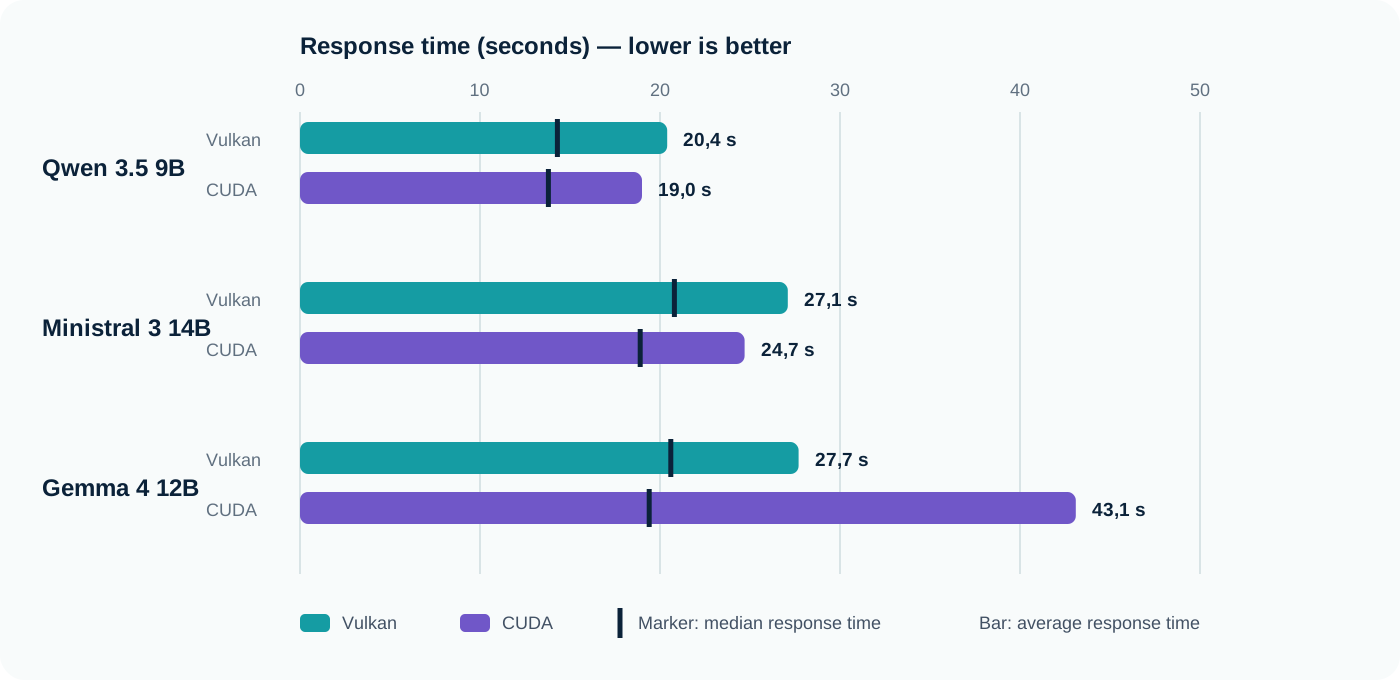
Temps de réponse
| Configuration | Moyenne | Médiane | Minimum | Maximum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vainqueur en vitesse
Qwen 3.5 9B sous CUDA est le plus rapide, aussi bien en moyenne qu’en médiane. Gemma CUDA mérite une explication : sa médiane est légèrement meilleure que sous Vulkan, mais un cas a généré 8 192 tokens pendant une phase de planification et a duré 4 min 33 s. Cet incident porte sa moyenne à 43,1 s.
Vulkan vs CUDA
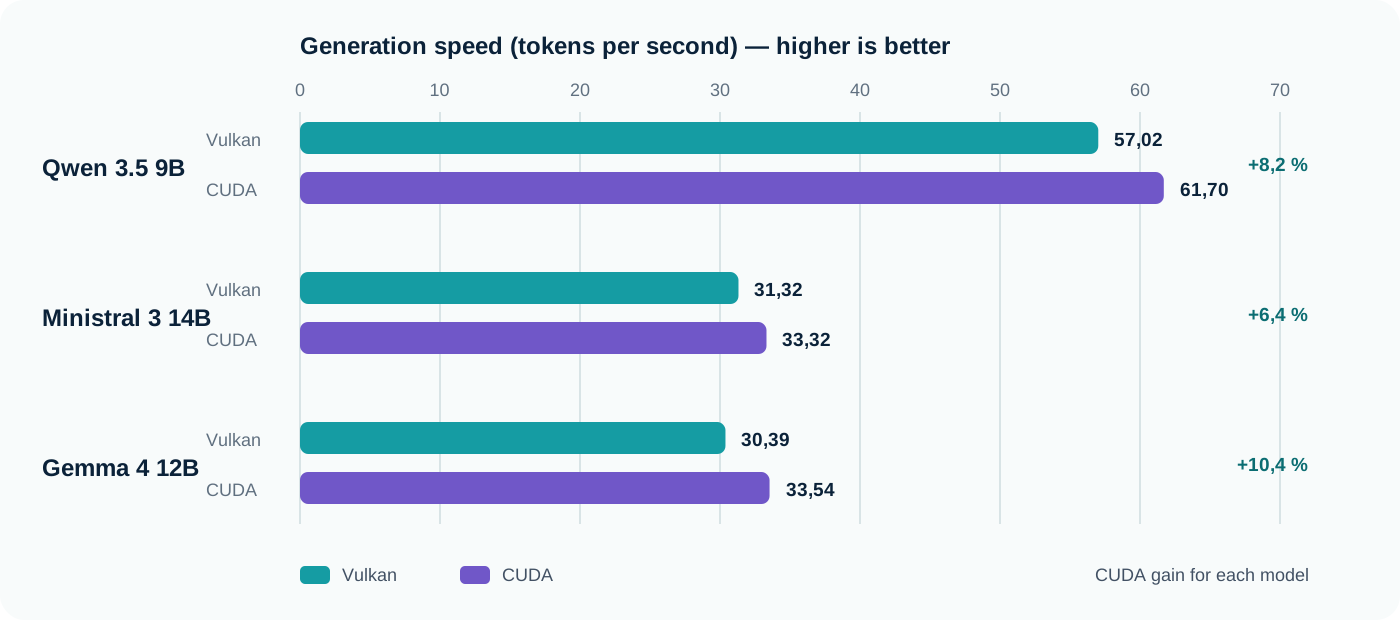
Génération : tokens par seconde
Le débit est agrégé en divisant le total des tokens générés par la durée totale de génération mesurée par llama.cpp. Il ne s’agit pas d’une moyenne simple des débits de chaque phase.
| Modèle | Vulkan | CUDA | Gain CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA gagne sur le débit brut pour les trois modèles. Cela ne garantit toutefois pas un meilleur temps total : les décisions du modèle et les appels d’outils pèsent souvent davantage que quelques tokens par seconde.
Temps moyen de réponse
CUDA réduit le temps moyen de Qwen d’environ 7 % et celui de Ministral d’environ 9 %. Pour Gemma, l’incident de planification fait augmenter la moyenne de 56 %, alors que la médiane baisse d’environ 5 %. La médiane décrit ici mieux le comportement habituel ; le maximum rappelle qu’un assistant local peut occasionnellement partir dans une génération très longue.
Le vainqueur n’est pas forcément le modèle le plus rapide
Qwen produit presque deux fois plus de tokens par seconde que les deux autres modèles, mais sa note humaine est nettement inférieure. Ministral offre un progrès important en qualité sans dégrader excessivement l’attente. Gemma obtient le meilleur score et réussit l’unique écriture avancée sur les deux backends, au prix d’une vitesse brute plus faible et d’un incident long sous CUDA.
Nous ne calculons pas de score composite arbitraire. Les usages n’accordent pas tous la même valeur à une seconde gagnée, à une réponse exacte ou à une action correctement exécutée.
Quel modèle choisir ?
Pour privilégier la vitesse
Qwen 3.5 9B Q4_K_M sous CUDA. Il est rapide et demande nettement moins de mémoire, mais son 8/15 appelle une vérification attentive dès que la demande dépasse une consultation simple.
Pour obtenir le meilleur équilibre
Ministral 3 14B Q5_K_M sous CUDA. Son score reste à 11/15 sur les deux backends et CUDA ramène sa médiane à 18,9 s. C’est un compromis solide pour les questions de consultation et d’analyse.
Pour privilégier avant tout la qualité
Gemma 4 12B Q6_K sous Vulkan. Avec 13/15 et l’action avancée réussie, il remporte ce comparatif. Gemma obtient la même note sous CUDA, mais Vulkan évite l’incident de planification qui allonge fortement la moyenne CUDA.
Conclusion
Sur cette RTX 5060 Ti 16 Go, aucun modèle ne domine tous les critères.
Qwen est le champion de la vitesse. Ministral propose le compromis le plus régulier entre attente et qualité. Gemma sous Vulkan donne les meilleurs résultats fonctionnels et se montre le plus convaincant pour les parcours complexes.
Le choix dépend donc du besoin : réponse rapide pour des consultations simples, équilibre pour un assistant quotidien, ou priorité maximale à la qualité et aux actions. Dans notre comparatif, Gemma 4 12B Q6_K remporte la qualité avec les deux backends ; nous préférons Vulkan pour sa régularité. Qwen 3.5 9B Q4_K_M sous CUDA remporte la vitesse.