Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: benchmark di LLM locali su RTX 5060 Ti
I modelli linguistici di piccole dimensioni hanno compiuto enormi progressi. Oggi è possibile eseguire localmente, su una scheda grafica destinata al grande pubblico, modelli capaci di interrogare un patrimonio, mettere in relazione più dati o persino preparare un’azione in un’applicazione.
Ma una domanda resta più utile di qualsiasi classifica di benchmark:
Domanda chiave: quale modello funziona davvero meglio in un’applicazione come My Wealth?
Abbiamo messo a confronto tre configurazioni proposte dai profili IA di My Wealth:
| Profilo My Wealth | Modello | Quantizzazione testata |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
La velocità in token al secondo conta, ma la priorità è ottenere una risposta esatta, fondata sui dati del portafoglio e prodotta con gli strumenti giusti. Confrontiamo quindi il successo funzionale, la qualità delle risposte, il tempo necessario e le prestazioni con Vulkan e CUDA.
La macchina di prova
Tutti i modelli sono stati eseguiti localmente sulla stessa macchina.
Scheda grafica
La NVIDIA GeForce RTX 5060 Ti da 16 GB appartiene alla generazione Blackwell. I suoi 16 GB di GDDR7 consentono di mantenere interamente sulla GPU i tre modelli quantizzati del confronto. NVIDIA propone questa scheda nelle versioni da 16 GB e 8 GB; abbiamo utilizzato la prima. Scheda ufficiale NVIDIA
Configurazione completa
| Componente | Configurazione misurata |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 core e 12 thread |
| RAM | 31,9 GiB |
| Sistema | Windows 11 Pro, build 26200 |
| Driver NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, build 10809 |
| Contesto | 32.768 token |
| Backend | prima Vulkan, poi CUDA |
Il modulo di elaborazione delle immagini di ogni modello è stato disattivato. I quindici casi sono esclusivamente testuali e questa impostazione evita di occupare memoria per un componente inutilizzato. Il massimo di memoria GPU osservato durante le esecuzioni è stato di circa 7,7 GiB per Qwen, 15,8 GiB per Ministral e 12,0 GiB per Gemma.
I tre modelli
Qwen 3.5 9B — il piccolo modello molto veloce
Qwen 3.5 9B è il più compatto dei tre. Il repository ufficiale lo presenta come un modello conversazionale multimodale con licenza Apache 2.0. Nella nostra prova testuale, il peso ridotto gli offre un netto vantaggio in velocità. Scheda ufficiale di Qwen 3.5 9B
In questa prova
Utilizziamo Qwen in Q4_K_M. È la configurazione più accessibile e veloce del confronto. Gestisce bene le richieste dirette, ma diventa meno regolare quando l’orchestrazione o la scrittura si fanno complesse.
Ministral 3 14B Instruct 2512 — il modello edge di Mistral AI
Ministral 3 14B è il modello più grande testato. Mistral lo destina in particolare alle installazioni locali ed edge; la versione Instruct supporta undici lingue e utilizza una licenza Apache 2.0. Scheda ufficiale di Ministral 3 14B Instruct
In questa prova
Utilizziamo Ministral in Q5_K_M. Per garantire un confronto Vulkan/CUDA simmetrico ed evitare il problema di memoria riscontrato con il suo precedente runtime, entrambe le esecuzioni impiegano lo stesso motore llama.cpp 0.4.0 di Gemma, senza modulo di elaborazione delle immagini. Il modello occupa quasi interamente i 16 GB disponibili, pur rimanendo stabile.
Gemma 4 12B — il miglior punteggio del confronto
Gemma 4 12B è un modello multimodale di Google con licenza Apache 2.0. La scheda ufficiale descrive input di testo, audio, immagini e video; qui viene utilizzata soltanto la componente testuale. Scheda ufficiale di Gemma 4 12B
In questa prova
Utilizziamo Gemma in Q6_K. Le sue dimensioni permettono di conservare una precisione maggiore rispetto a Ministral Q5, restando entro la memoria della scheda. È inoltre l’unico concorrente che completa con successo l’azione avanzata.
La quantizzazione come variabile di adattamento all’hardware
I tre modelli non sono testati con la stessa quantizzazione: Q4_K_M per Qwen, Q5_K_M per Ministral e Q6_K per Gemma. La scelta corrisponde ai profili realmente utilizzabili in My Wealth e al loro hardware di destinazione.
| Modello | Quantizzazione | Memoria GPU massima osservata |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Questo benchmark confronta quindi delle configurazioni di prodotto. I risultati non pretendono di isolare la sola architettura dei modelli.
Il protocollo di prova di My Wealth
Il banco di prova completo di My Wealth contiene 354 domande e azioni. Ne abbiamo selezionate 15 prima di qualsiasi misurazione:
| Categoria | Numero | Oggetto |
|---|---|---|
| Basic | 8 | Consultazioni dirette del patrimonio |
| Intermediate | 2 | Collegamento di più dati |
| Advanced | 2 | Analisi e percorsi di strumenti più elaborati |
| Write | 2 | Azione semplice o rifiuto sicuro di un’azione impossibile |
| Write Advanced | 1 | Creazione completa con più campi |
| Totale | 15 |
Ogni configurazione ha elaborato esattamente gli stessi casi, prima con Vulkan e poi con CUDA. Il modello restava caricato durante le sue quindici prove. Un’esecuzione di riscaldamento era esclusa dalle misure e il patrimonio sintetico, così come la conversazione, veniva reinizializzato per ogni caso. È stato considerato un solo tentativo misurato; un errore del modello resta un risultato.
Che cosa misuriamo
1. Successo funzionale
I 90 risultati sono stati riletti manualmente. Per una consultazione, valutiamo l’esattezza e la completezza della risposta visibile rispetto ai dati sintetici. Una chiamata ridondante a uno strumento non trasforma una buona risposta in un fallimento. Per una scrittura, verifichiamo l’effetto realmente registrato e ciascun campo richiesto: una semplice affermazione di successo non basta.
2. Qualità della risposta
Esaminiamo separatamente le risposte visibili: esattezza, chiarezza, fedeltà ai dati e utilità. Questa revisione umana determina il punteggio pubblicato.
3. Tempo di risposta
Il tempo totale include la selezione degli strumenti, la pianificazione, le relative chiamate e la risposta finale. Rappresenta meglio l’attesa reale rispetto alla sola velocità di generazione.
4. Vulkan contro CUDA
Per ogni modello, le due esecuzioni utilizzano lo stesso GGUF, lo stesso template, lo stesso motore e gli stessi parametri. Cambia soltanto il backend GPU.
Risultati — qualità delle risposte
Risultato complessivo
| Configurazione | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, pari al 60% | 8/15, pari al 53% |
| Ministral 3 14B Q5_K_M | 11/15, pari al 73% | 11/15, pari al 73% |
| Gemma 4 12B Q6_K | 13/15, pari all’87% | 13/15, pari all’87% |
Vincitore per qualità
Gemma 4 12B Q6_K ottiene il miglior risultato con entrambi i backend, con 13 successi su 15. Ministral è secondo con 11/15. Qwen ottiene 9/15 con Vulkan e 8/15 con CUDA.
Risultati per categoria
Ecco un esempio concreto di richiesta per ogni categoria:
| Categoria | Esempio di richiesta testata |
|---|---|
| Basic | «Qual è l’importo totale delle mie passività?» |
| Intermediate | «Confronta il valore dei miei risparmi con quello dei miei debiti.» |
| Advanced | «Per il solo obiettivo Pensione serena, quali sono l’avanzamento attuale e lo sforzo mensile richiesto?» |
| Write | «Aggiungi “Crédit Mutuel” ai miei istituti.» |
| Write Advanced | «Aggiungi presso Banque Horizon un supporto “Conto Lavori” […] detenuto al 100% da Benoît Martin.» |
| Modello e backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Tutti e tre i modelli falliscono nei due casi Write. Il primo chiedeva di aggiungere un istituto; nessuno ha portato a termine la modifica. Il secondo chiedeva di modificare direttamente un valore derivato dalla quotazione dell’oro: i modelli avrebbero dovuto spiegare chiaramente che questa scrittura isolata non era supportata, ma i loro percorsi si sono protratti fino ai limiti di generazione o degli strumenti.
Alcune risposte che ci hanno sorpreso
Esempio 1 — un’eccellente risposta avanzata
Alla domanda sull’obiettivo «Pensione serena», Ministral e Gemma ritrovano i due valori attesi. Ministral risponde in particolare:
«Avanzamento attuale: 29,67% […] Sforzo mensile richiesto: 858,88 €.»
La risposta è breve, quantificata e fondata sul corretto percorso di consultazione.
Esempio 2 — una risposta plausibile… ma errata
Qwen risponde che la quota degli attivi finanziata dalle passività è del 13,70% con Vulkan e del 15,94% con CUDA, mentre il valore atteso è 17,81%. I calcoli sembrano credibili, ma il modello omette una parte delle passività o sceglie un denominatore sbagliato.
Questo errore mostra perché la forma convincente di una risposta finanziaria non basta.
Esempio 3 — quando l’uso degli strumenti fa la differenza
Alla richiesta di creare il supporto bancario «Conto Lavori», Gemma applica esattamente tutti i campi richiesti sia con Vulkan sia con CUDA: istituto, valuta, riferimento, versamento, monitoraggio, proprietario e nota.
Ministral crea il supporto, ma omette l’istituto e la nota nell’effetto realmente registrato, nonostante una risposta che afferma il contrario. Qwen non applica alcuna modifica. L’esempio mostra perché la verifica delle scritture deve riguardare lo stato registrato, non soltanto il testo finale.
Risultati — velocità reale in My Wealth
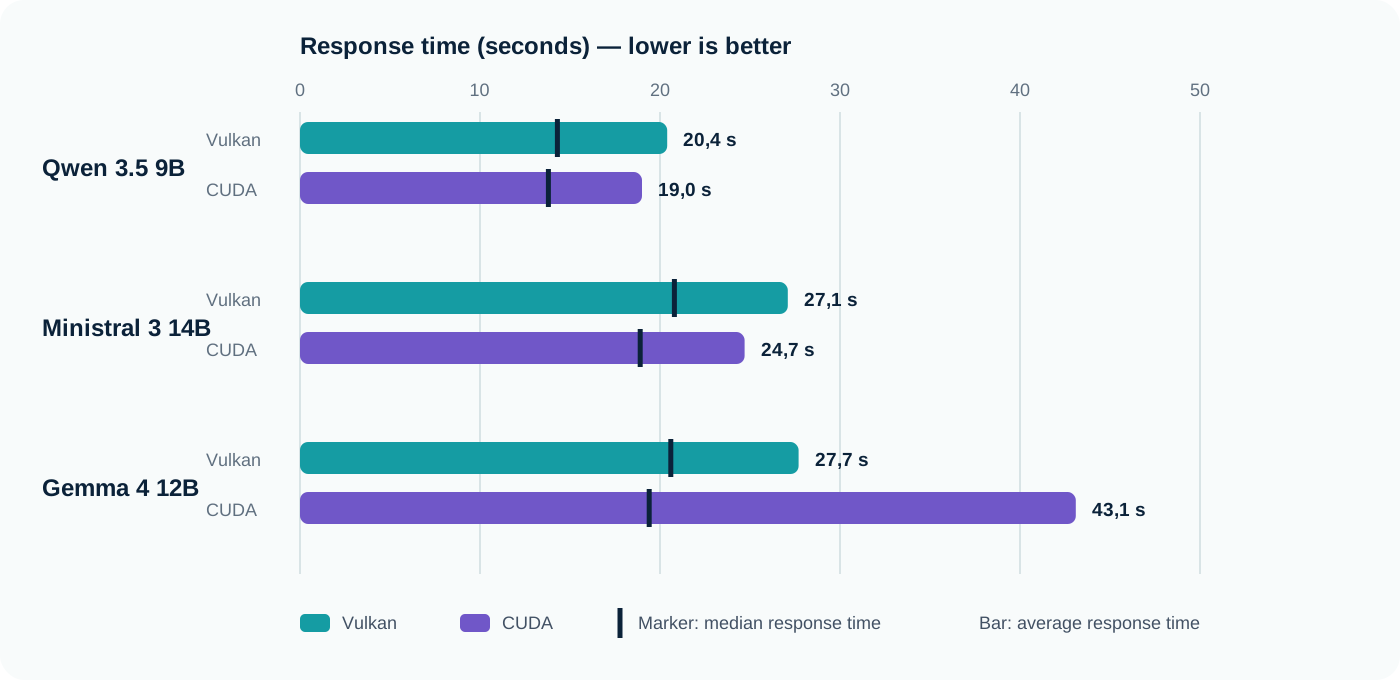
Tempo di risposta
| Configurazione | Media | Mediana | Minimo | Massimo |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vincitore per velocità
Qwen 3.5 9B con CUDA è il più veloce, sia in media sia in mediana. Gemma CUDA merita una spiegazione: la mediana è leggermente migliore rispetto a Vulkan, ma un caso ha generato 8.192 token durante una fase di pianificazione ed è durato 4 min 33 s. Questo incidente porta la media a 43,1 s.
Vulkan vs CUDA
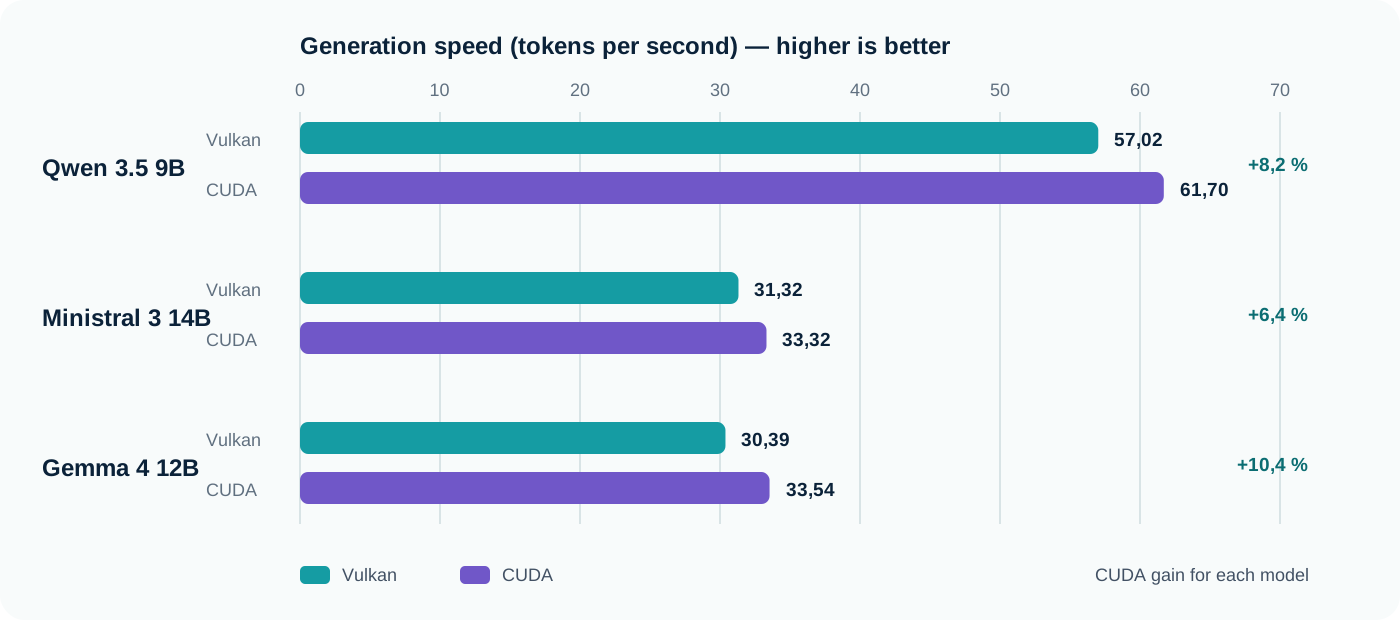
Generazione: token al secondo
La velocità è aggregata dividendo il totale dei token generati per la durata totale della generazione misurata da llama.cpp. Non si tratta di una semplice media delle velocità di ogni fase.
| Modello | Vulkan | CUDA | Guadagno CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2% |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4% |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4% |
CUDA vince sulla velocità grezza per tutti e tre i modelli. Ciò non garantisce tuttavia un tempo totale migliore: le decisioni del modello e le chiamate agli strumenti pesano spesso più di qualche token al secondo.
Tempo medio di risposta
CUDA riduce il tempo medio di Qwen di circa il 7% e quello di Ministral di circa il 9%. Per Gemma, l’incidente di pianificazione fa aumentare la media del 56%, mentre la mediana scende di circa il 5%. Qui la mediana descrive meglio il comportamento abituale; il massimo ricorda che un assistente locale può occasionalmente avventurarsi in una generazione molto lunga.
Il vincitore non è necessariamente il modello più veloce
Qwen produce quasi il doppio dei token al secondo rispetto agli altri due modelli, ma il suo punteggio umano è nettamente inferiore. Ministral offre un progresso importante in termini di qualità senza peggiorare eccessivamente l’attesa. Gemma ottiene il miglior punteggio e completa con successo l’unica scrittura avanzata con entrambi i backend, al prezzo di una velocità grezza inferiore e di un lungo incidente con CUDA.
Non calcoliamo un punteggio composito arbitrario. Non tutti gli utilizzi attribuiscono lo stesso valore a un secondo risparmiato, a una risposta esatta o a un’azione eseguita correttamente.
Quale modello scegliere?
Per privilegiare la velocità
Qwen 3.5 9B Q4_K_M con CUDA. È veloce e richiede molta meno memoria, ma il punteggio di 8/15 impone una verifica attenta non appena la richiesta va oltre una semplice consultazione.
Per ottenere il miglior equilibrio
Ministral 3 14B Q5_K_M con CUDA. Il punteggio resta di 11/15 con entrambi i backend e CUDA porta la mediana a 18,9 s. È un compromesso solido per le domande di consultazione e analisi.
Per privilegiare soprattutto la qualità
Gemma 4 12B Q6_K con Vulkan. Con 13/15 e l’azione avanzata completata, vince il confronto. Gemma ottiene lo stesso punteggio con CUDA, ma Vulkan evita l’incidente di pianificazione che allunga notevolmente la media di CUDA.
Conclusione
Su questa RTX 5060 Ti da 16 GB, nessun modello domina tutti i criteri.
Qwen è il campione della velocità. Ministral propone il compromesso più regolare fra attesa e qualità. Gemma con Vulkan offre i migliori risultati funzionali e risulta il più convincente per i percorsi complessi.
La scelta dipende quindi dall’esigenza: risposta rapida per consultazioni semplici, equilibrio per un assistente quotidiano oppure massima priorità alla qualità e alle azioni. Nel nostro confronto, Gemma 4 12B Q6_K vince per qualità con entrambi i backend; preferiamo Vulkan per la sua regolarità. Qwen 3.5 9B Q4_K_M con CUDA vince per velocità.