Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: benchmark van lokale LLM’s op een RTX 5060 Ti
Kleine taalmodellen zijn enorm vooruitgegaan. Het is inmiddels mogelijk om op een grafische kaart voor consumenten lokaal modellen uit te voeren die een vermogen kunnen doorzoeken, meerdere gegevens kunnen combineren of een actie in een applicatie kunnen voorbereiden.
Maar één vraag is nuttiger dan een ranglijst van benchmarks:
Kernvraag: welk model werkt daadwerkelijk het best in een applicatie als My Wealth?
We hebben drie configuraties uit de AI-profielen van My Wealth met elkaar vergeleken:
| My Wealth-profiel | Model | Geteste kwantisatie |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
De snelheid in tokens per seconde telt, maar het belangrijkste is een correct antwoord dat op de portefeuilledata is gebaseerd en met de juiste tools is gemaakt. Daarom vergelijken we functioneel succes, antwoordkwaliteit, benodigde tijd en prestaties met Vulkan en CUDA.
De testmachine
Alle modellen zijn lokaal op dezelfde machine uitgevoerd.
Grafische kaart
De NVIDIA GeForce RTX 5060 Ti 16 GB behoort tot de Blackwell-generatie. Dankzij 16 GB GDDR7 passen de drie gekwantiseerde modellen uit deze vergelijking volledig in het GPU-geheugen. NVIDIA biedt deze kaart met 16 GB en 8 GB aan; wij gebruikten de eerste versie. Officiële NVIDIA-productpagina
Volledige configuratie
| Onderdeel | Gemeten configuratie |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16.311 MiB |
| CPU | AMD Ryzen 5 2600, 6 cores en 12 threads |
| RAM | 31,9 GiB |
| Systeem | Windows 11 Professional, build 26200 |
| NVIDIA-driver | 616.56 |
| Runtime | llama.cpp 0.4.0, build 10809 |
| Context | 32.768 tokens |
| Backends | Eerst Vulkan, daarna CUDA |
De beeldmodule van elk model was uitgeschakeld. De vijftien gevallen zijn uitsluitend tekstueel; zo neemt een ongebruikt onderdeel geen geheugen in beslag. Het hoogst waargenomen GPU-geheugengebruik tijdens de runs bedroeg ongeveer 7,7 GiB voor Qwen, 15,8 GiB voor Ministral en 12,0 GiB voor Gemma.
De drie modellen
Qwen 3.5 9B — het zeer snelle kleine model
Qwen 3.5 9B is het compactste van de drie. De officiële repository presenteert het als een multimodaal conversatiemodel onder de Apache 2.0-licentie. In onze tekstuele test geeft zijn beperkte omvang het model een duidelijke snelheidsvoorsprong. Officiële pagina van Qwen 3.5 9B
In deze test
We gebruiken Qwen in Q4_K_M. Dit is de toegankelijkste en snelste configuratie in de vergelijking. Rechtstreekse verzoeken verwerkt het goed, maar zodra de orkestratie of een schrijfactie ingewikkeld wordt, is het minder consistent.
Ministral 3 14B Instruct 2512 — het edge-model van Mistral AI
Ministral 3 14B is het grootste geteste model. Mistral richt het onder meer op lokale en edge-implementaties; de Instruct-versie ondersteunt elf talen en gebruikt een Apache 2.0-licentie. Officiële pagina van Ministral 3 14B Instruct
In deze test
We gebruiken Ministral in Q5_K_M. Om Vulkan en CUDA symmetrisch te vergelijken en het geheugenprobleem met de eerdere runtime te vermijden, gebruiken beide runs dezelfde llama.cpp 0.4.0-engine als Gemma, zonder beeldmodule. Het model benut vrijwel alle beschikbare 16 GB, maar blijft stabiel.
Gemma 4 12B — de hoogste score in deze vergelijking
Gemma 4 12B is een multimodaal model van Google onder de Apache 2.0-licentie. De officiële pagina beschrijft invoer van tekst, audio, afbeeldingen en video; hier gebruiken we alleen het tekstgedeelte. Officiële pagina van Gemma 4 12B
In deze test
We gebruiken Gemma in Q6_K. Dankzij zijn omvang kan het meer precisie behouden dan Ministral Q5 en toch binnen het geheugenbudget van de kaart blijven. Het is bovendien de enige deelnemer die de geavanceerde actie succesvol uitvoert.
Kwantisatie als afstemming op de hardware
De drie modellen zijn niet met dezelfde kwantisatie getest: Q4_K_M voor Qwen, Q5_K_M voor Ministral en Q6_K voor Gemma. Deze keuze weerspiegelt de configuraties die daadwerkelijk bruikbaar zijn in My Wealth en de hardware waarop ze zijn gericht.
| Model | Kwantisatie | Hoogst waargenomen GPU-geheugen |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Deze benchmark vergelijkt dus productconfiguraties. De resultaten beweren niet uitsluitend de architectuur van de modellen te isoleren.
Het testprotocol van My Wealth
De volledige testset van My Wealth bevat 354 vragen en acties. Daaruit hebben we er 15 vastgelegd voordat er werd gemeten:
| Categorie | Aantal | Doel |
|---|---|---|
| Basic | 8 | Rechtstreekse raadplegingen van het vermogen |
| Intermediate | 2 | Combineren van meerdere gegevens |
| Advanced | 2 | Uitgebreidere analyse en tooltrajecten |
| Write | 2 | Eenvoudige actie of veilige weigering van een onmogelijke actie |
| Write Advanced | 1 | Volledige creatie met meerdere velden |
| Totaal | 15 |
Elke configuratie verwerkte exact dezelfde gevallen, eerst met Vulkan en daarna met CUDA. Een model bleef tijdens zijn vijftien tests geladen. Eén opwarmrun telde niet mee; het synthetische vermogen en het gesprek werden voor elk geval opnieuw ingesteld. We behielden slechts één gemeten poging: een fout van het model blijft een resultaat.
Wat we meten
1. Functioneel succes
Alle 90 resultaten zijn handmatig nagekeken. Bij een raadpleging beoordelen we het zichtbare antwoord op juistheid en volledigheid ten opzichte van de synthetische gegevens. Een overbodige toolaanroep maakt van een goed antwoord geen mislukking. Bij een schrijfactie controleren we het daadwerkelijk opgeslagen effect en elk gevraagd veld: alleen beweren dat de actie is gelukt, is niet genoeg.
2. Kwaliteit van het antwoord
We beoordelen de zichtbare antwoorden afzonderlijk op juistheid, helderheid, trouw aan de gegevens en bruikbaarheid. Deze menselijke beoordeling bepaalt de gepubliceerde score.
3. Responstijd
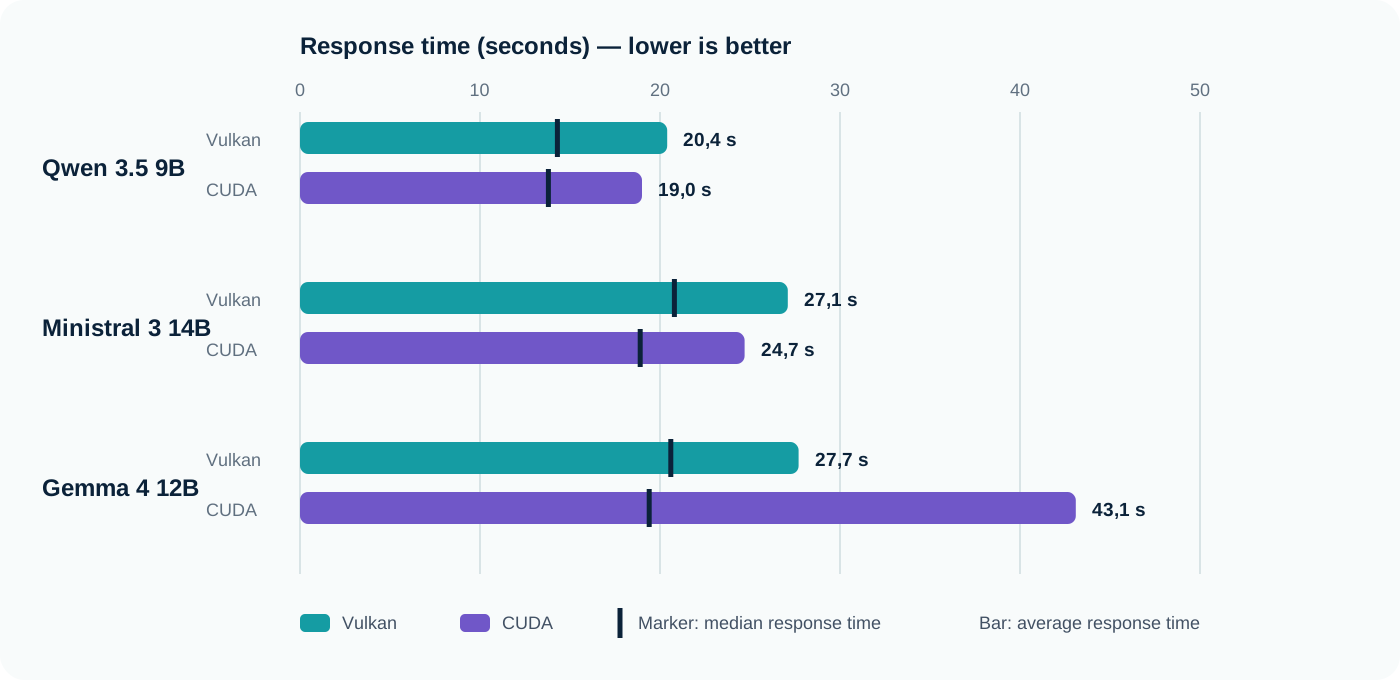
De totale tijd omvat de selectie van tools, de planning, de toolaanroepen en het uiteindelijke antwoord. Dat geeft de ervaren wachttijd beter weer dan alleen de generatiesnelheid.
4. Vulkan tegenover CUDA
Voor elk model gebruiken de twee runs hetzelfde GGUF-bestand, dezelfde template, dezelfde engine en dezelfde parameters. Alleen de GPU-backend verandert.
Resultaten — kwaliteit van de antwoorden
Totaalresultaat
| Configuratie | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, oftewel 60% | 8/15, oftewel 53% |
| Ministral 3 14B Q5_K_M | 11/15, oftewel 73% | 11/15, oftewel 73% |
| Gemma 4 12B Q6_K | 13/15, oftewel 87% | 13/15, oftewel 87% |
Winnaar op kwaliteit
Gemma 4 12B Q6_K behaalt met beide backends het beste resultaat: 13 van de 15 gevallen slagen. Ministral wordt tweede met 11/15. Qwen behaalt 9/15 met Vulkan en 8/15 met CUDA.
Resultaten per categorie
Hieronder staat voor elke categorie een concreet voorbeeld van een geteste opdracht:
| Categorie | Voorbeeld van een geteste opdracht |
|---|---|
| Basic | ‘Wat is het totaalbedrag van mijn verplichtingen?’ |
| Intermediate | ‘Vergelijk de waarde van mijn spaargeld met die van mijn schulden.’ |
| Advanced | ‘Wat is voor uitsluitend het doel Zorgeloos pensioen de huidige voortgang en de vereiste maandelijkse inleg?’ |
| Write | ‘Voeg “Crédit Mutuel” toe aan mijn instellingen.’ |
| Write Advanced | ‘Voeg bij Banque Horizon een rekening “Compte Travaux” toe […] die voor 100% eigendom is van Benoît Martin.’ |
| Model en backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Alle drie de modellen falen in de twee Write-gevallen. In het eerste geval moest een instelling worden toegevoegd; geen enkel model voltooide de wijziging. In het tweede moest rechtstreeks een waarde worden aangepast die van de goudkoers was afgeleid. De modellen hadden duidelijk moeten uitleggen dat deze geïsoleerde schrijfactie niet werd ondersteund, maar hun trajecten gingen door totdat de generatie- of toollimiet was bereikt.
Enkele antwoorden die ons verrasten
Voorbeeld 1 — een uitstekend geavanceerd antwoord
Op de vraag over het doel ‘Zorgeloos pensioen’ vinden Ministral en Gemma de twee verwachte waarden. Ministral antwoordt onder meer:
‘Huidige voortgang: 29,67% […] Vereiste maandelijkse inleg: € 858,88.’
Het antwoord is kort, cijfermatig en gebaseerd op het juiste raadpleegtraject.
Voorbeeld 2 — een aannemelijk antwoord… dat onjuist is
Qwen antwoordt dat het door verplichtingen gefinancierde aandeel van de activa 13,70% bedraagt met Vulkan en 15,94% met CUDA, terwijl de verwachte waarde 17,81% is. De berekeningen lijken geloofwaardig, maar het model laat een deel van de verplichtingen weg of kiest een verkeerde noemer.
Deze fout laat zien waarom een overtuigend geformuleerd financieel antwoord op zichzelf niet genoeg is.
Voorbeeld 3 — wanneer het gebruik van tools het verschil maakt
Bij de opdracht om de bankrekening ‘Compte Travaux’ aan te maken, past Gemma zowel met Vulkan als CUDA exact alle gevraagde velden toe: instelling, valuta, referentie, storting, tracking, eigenaar en notitie.
Ministral maakt wel een rekening aan, maar laat de instelling en notitie weg uit het daadwerkelijk opgeslagen resultaat, ondanks een antwoord dat het tegendeel beweert. Qwen voert geen enkele wijziging uit. Dit voorbeeld laat zien waarom schrijfacties op de opgeslagen status moeten worden beoordeeld en niet alleen op de uiteindelijke tekst.
Resultaten — werkelijke snelheid in My Wealth
Responstijd
| Configuratie | Gemiddelde | Mediaan | Minimum | Maximum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Winnaar op snelheid
Qwen 3.5 9B met CUDA is het snelst, zowel gemiddeld als op basis van de mediaan. Gemma CUDA verdient uitleg: de mediaan is iets beter dan met Vulkan, maar in één geval werden tijdens de planningsfase 8.192 tokens gegenereerd en duurde het proces 4 min 33 s. Door dit incident stijgt het gemiddelde tot 43,1 s.
Vulkan vs CUDA
Generatie: tokens per seconde
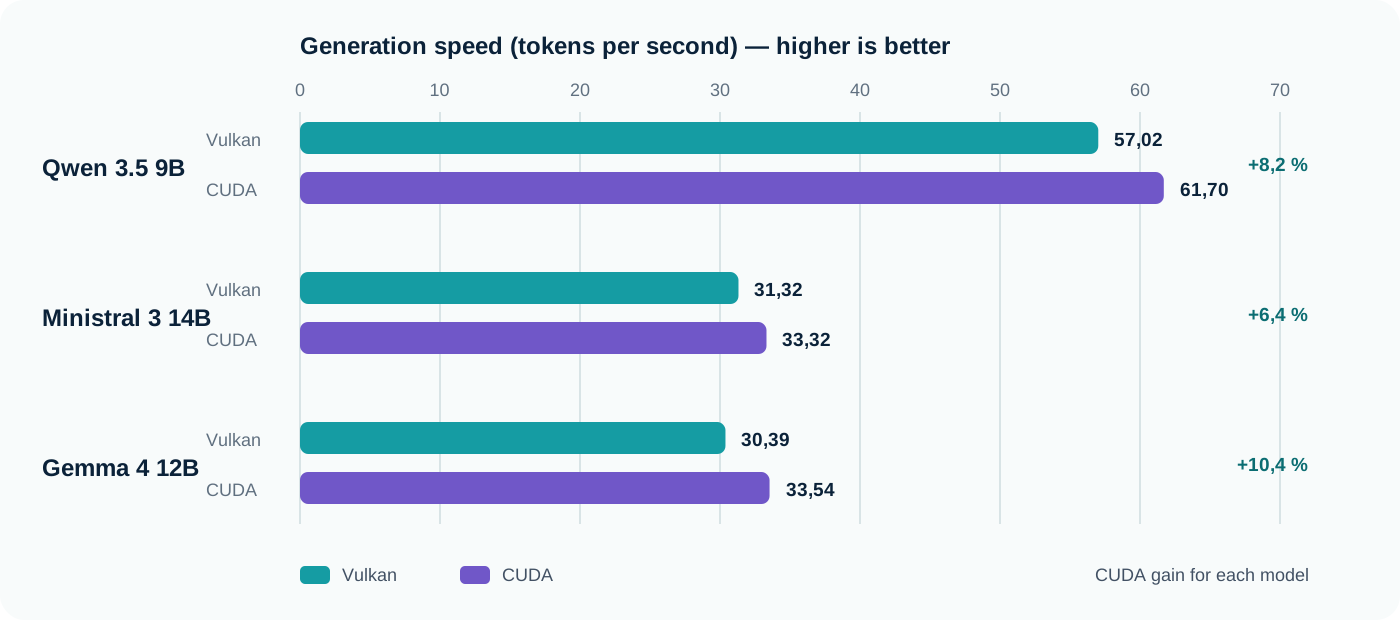
De snelheid is geaggregeerd door het totale aantal gegenereerde tokens te delen door de totale generatieduur die llama.cpp heeft gemeten. Het is geen eenvoudig gemiddelde van de snelheden in elke fase.
| Model | Vulkan | CUDA | CUDA-winst |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2% |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4% |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4% |
CUDA wint bij alle drie de modellen op ruwe doorvoer. Dat garandeert echter geen betere totale tijd: de beslissingen van het model en de toolaanroepen wegen vaak zwaarder dan enkele tokens per seconde.
Gemiddelde responstijd
CUDA verkort de gemiddelde tijd van Qwen met ongeveer 7% en die van Ministral met ongeveer 9%. Bij Gemma verhoogt het planningsincident het gemiddelde met 56%, terwijl de mediaan met ongeveer 5% daalt. De mediaan beschrijft hier het gebruikelijke gedrag beter; het maximum herinnert eraan dat een lokale assistent soms in een zeer lange generatie kan belanden.
De winnaar is niet noodzakelijk het snelste model
Qwen genereert bijna twee keer zoveel tokens per seconde als de andere twee modellen, maar de menselijke beoordeling is duidelijk lager. Ministral levert een flinke kwaliteitsverbetering zonder de wachttijd buitensporig te verlengen. Gemma behaalt de beste score en slaagt met beide backends in de enige geavanceerde schrijfactie, ten koste van een lagere ruwe snelheid en één langdurig incident met CUDA.
We berekenen geen willekeurige samengestelde score. Niet elk gebruiksscenario kent dezelfde waarde toe aan een gewonnen seconde, een correct antwoord of een juist uitgevoerde actie.
Welk model kiest u?
Als snelheid vooropstaat
Qwen 3.5 9B Q4_K_M met CUDA. Het is snel en vraagt aanzienlijk minder geheugen, maar de score van 8/15 vraagt om zorgvuldige controle zodra een verzoek verdergaat dan een eenvoudige raadpleging.
Voor de beste balans
Ministral 3 14B Q5_K_M met CUDA. De score blijft met beide backends 11/15 en CUDA brengt de mediaan terug tot 18,9 s. Het is een solide compromis voor raadplegings- en analysevragen.
Als kwaliteit boven alles gaat
Gemma 4 12B Q6_K met Vulkan. Met 13/15 en een geslaagde geavanceerde actie wint het deze vergelijking. Gemma behaalt met CUDA dezelfde score, maar Vulkan vermijdt het planningsincident dat het CUDA-gemiddelde sterk verhoogt.
Conclusie
Op deze RTX 5060 Ti 16 GB domineert geen enkel model op alle criteria.
Qwen is de snelheidskampioen. Ministral biedt het consistentste compromis tussen wachttijd en kwaliteit. Gemma met Vulkan levert de beste functionele resultaten en overtuigt het meest bij complexe trajecten.
De keuze hangt dus af van uw behoefte: een snel antwoord bij eenvoudige raadplegingen, balans voor een dagelijkse assistent of maximale prioriteit voor kwaliteit en acties. In onze vergelijking wint Gemma 4 12B Q6_K met beide backends op kwaliteit; vanwege de consistentie geven we de voorkeur aan Vulkan. Qwen 3.5 9B Q4_K_M met CUDA wint op snelheid.