Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: comparativo de LLM locais numa RTX 5060 Ti
Os modelos de linguagem pequenos evoluíram enormemente. Hoje é possível executar localmente, numa placa gráfica de consumo, modelos capazes de consultar um património, relacionar vários dados ou até preparar uma ação numa aplicação.
Mas há uma pergunta mais útil do que qualquer classificação de benchmarks:
Pergunta-chave: que modelo funciona realmente melhor numa aplicação como o My Wealth?
Confrontámos três configurações propostas pelos perfis de IA do My Wealth:
| Perfil do My Wealth | Modelo | Quantização testada |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
O débito em tokens por segundo é importante, mas a prioridade é obter uma resposta exata, baseada nos dados da carteira e produzida com as ferramentas certas. Por isso, comparamos o sucesso funcional, a qualidade das respostas, o tempo necessário e o desempenho com Vulkan e CUDA.
A máquina de teste
Todos os modelos foram executados localmente na mesma máquina.
Placa gráfica
A NVIDIA GeForce RTX 5060 Ti de 16 GB pertence à geração Blackwell. Os seus 16 GB de GDDR7 permitem manter integralmente na GPU os três modelos quantizados deste comparativo. A NVIDIA disponibiliza esta placa em versões de 16 GB e 8 GB; utilizámos a primeira. Ficha oficial da NVIDIA
Configuração completa
| Componente | Configuração medida |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 MiB |
| CPU | AMD Ryzen 5 2600, 6 núcleos e 12 threads |
| RAM | 31,9 GiB |
| Sistema | Windows 11 Pro, compilação 26200 |
| Controlador NVIDIA | 616.56 |
| Runtime | llama.cpp 0.4.0, compilação 10809 |
| Contexto | 32 768 tokens |
| Backends | primeiro Vulkan e depois CUDA |
O módulo de imagem de cada modelo foi desativado. Os quinze casos são exclusivamente textuais e esta definição evita ocupar memória com um componente não utilizado. O máximo de memória GPU observado durante as execuções foi de aproximadamente 7,7 GiB para o Qwen, 15,8 GiB para o Ministral e 12,0 GiB para o Gemma.
Os três modelos
Qwen 3.5 9B — o pequeno modelo muito rápido
O Qwen 3.5 9B é o mais compacto dos três. O repositório oficial apresenta-o como um modelo conversacional multimodal sob licença Apache 2.0. No nosso teste textual, o seu tamanho reduzido dá-lhe uma vantagem clara em velocidade. Ficha oficial do Qwen 3.5 9B
Neste teste
Utilizamos o Qwen em Q4_K_M. É a configuração mais acessível e rápida do comparativo. Lida bem com pedidos diretos, mas torna-se menos consistente quando a orquestração ou a escrita ficam complexas.
Ministral 3 14B Instruct 2512 — o modelo edge da Mistral AI
O Ministral 3 14B é o maior modelo testado. A Mistral destina-o em especial a implementações locais e edge; a sua versão Instruct suporta onze idiomas e utiliza uma licença Apache 2.0. Ficha oficial do Ministral 3 14B Instruct
Neste teste
Utilizamos o Ministral em Q5_K_M. Para garantir uma comparação Vulkan/CUDA simétrica e evitar o problema de memória observado com o runtime anterior, ambas as execuções utilizam o mesmo motor llama.cpp 0.4.0 do Gemma, sem módulo de imagem. O modelo ocupa quase todos os 16 GB disponíveis, mantendo-se estável.
Gemma 4 12B — a melhor pontuação deste comparativo
O Gemma 4 12B é um modelo multimodal da Google sob licença Apache 2.0. A sua ficha oficial descreve entradas de texto, áudio, imagem e vídeo; aqui utilizamos apenas a parte textual. Ficha oficial do Gemma 4 12B
Neste teste
Utilizamos o Gemma em Q6_K. O seu tamanho permite conservar mais precisão do que o Ministral Q5, mantendo-se dentro da capacidade de memória da placa. É também o único concorrente que conclui com sucesso a ação avançada.
A quantização como variável de adaptação ao hardware
Os três modelos não são testados com a mesma quantização: Q4_K_M para o Qwen, Q5_K_M para o Ministral e Q6_K para o Gemma. Esta escolha corresponde aos perfis realmente utilizáveis no My Wealth e ao respetivo hardware-alvo.
| Modelo | Quantização | Memória GPU máxima observada |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Este benchmark compara, portanto, configurações de produto. Os resultados não pretendem isolar apenas a arquitetura dos modelos.
O protocolo de teste do My Wealth
O banco completo do My Wealth contém 354 perguntas e ações. Fixámos 15 antes de qualquer medição:
| Categoria | Número | Objeto |
|---|---|---|
| Basic | 8 | Consultas diretas ao património |
| Intermediate | 2 | Relacionamento de vários dados |
| Advanced | 2 | Análise e percursos de ferramentas mais elaborados |
| Write | 2 | Ação simples ou recusa segura de uma ação impossível |
| Write Advanced | 1 | Criação completa com vários campos |
| Total | 15 |
Cada configuração processou exatamente os mesmos casos, primeiro com Vulkan e depois com CUDA. O modelo permanecia carregado durante os quinze testes. Uma execução de aquecimento foi excluída das medições, e o património sintético e a conversa eram reiniciados para cada caso. Foi considerada uma única tentativa medida; um erro do modelo continua a ser um resultado.
O que medimos
1. Sucesso funcional
Os 90 resultados foram revistos manualmente. Numa consulta, avaliamos a exatidão e a integridade da resposta visível face aos dados sintéticos. Uma chamada redundante a uma ferramenta não transforma uma boa resposta num fracasso. Numa escrita, verificamos o efeito efetivamente registado e cada um dos campos pedidos: uma simples afirmação de sucesso não basta.
2. Qualidade da resposta
Revemos separadamente as respostas visíveis: exatidão, clareza, fidelidade aos dados e utilidade. Esta revisão humana determina a pontuação publicada.
3. Tempo de resposta
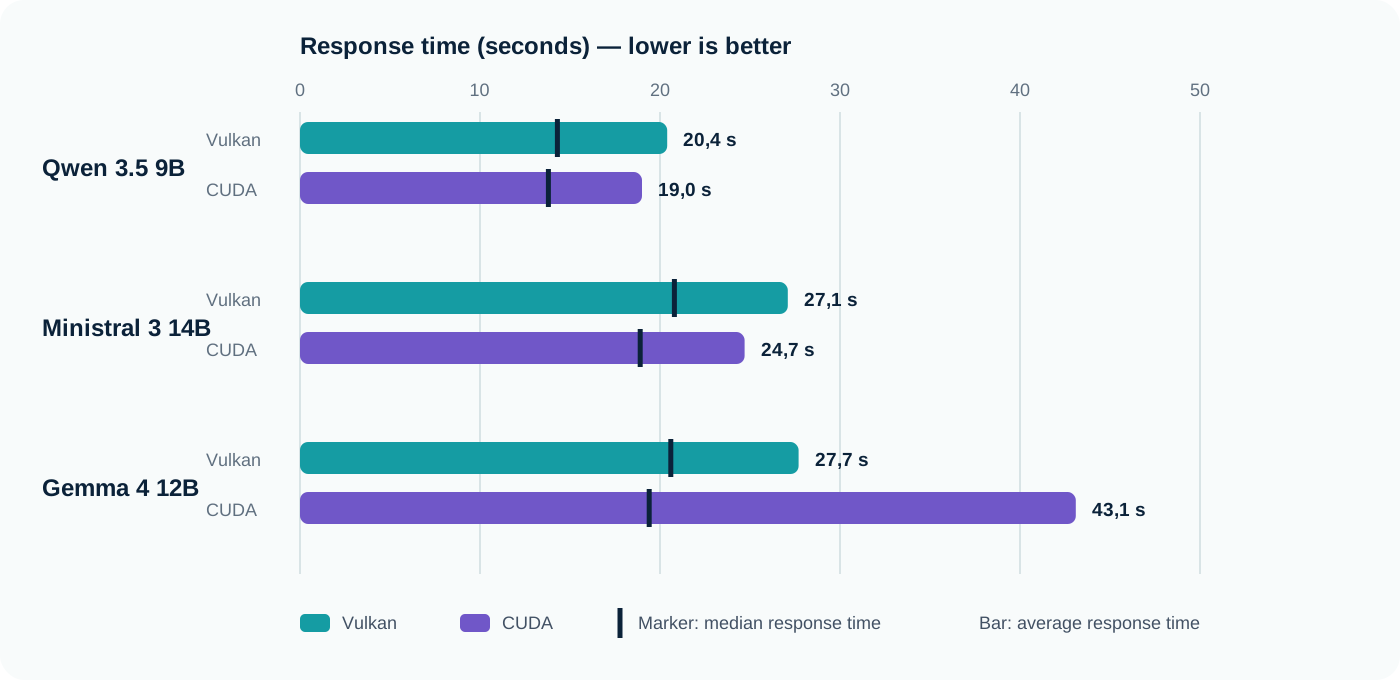
O tempo total inclui a seleção das ferramentas, o planeamento, as chamadas e a resposta final. Representa melhor a espera sentida do que um débito de geração considerado isoladamente.
4. Vulkan contra CUDA
Para cada modelo, as duas execuções utilizam o mesmo GGUF, o mesmo template, o mesmo motor e os mesmos parâmetros. Só muda o backend da GPU.
Resultados — qualidade das respostas
Resultado global
| Configuração | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, ou seja, 60% | 8/15, ou seja, 53% |
| Ministral 3 14B Q5_K_M | 11/15, ou seja, 73% | 11/15, ou seja, 73% |
| Gemma 4 12B Q6_K | 13/15, ou seja, 87% | 13/15, ou seja, 87% |
Vencedor em qualidade
O Gemma 4 12B Q6_K obtém o melhor resultado nos dois backends, com 13 sucessos em 15. O Ministral fica em segundo lugar com 11/15. O Qwen obtém 9/15 com Vulkan e 8/15 com CUDA.
Resultados por categoria
Eis um exemplo concreto de pedido para cada categoria:
| Categoria | Exemplo de pedido testado |
|---|---|
| Basic | «Qual é o montante total do meu passivo?» |
| Intermediate | «Compara o valor das minhas poupanças com o das minhas dívidas.» |
| Advanced | «Apenas para o objetivo Reforma tranquila, qual é o progresso atual e o esforço mensal necessário?» |
| Write | «Adiciona o “Crédit Mutuel” às minhas instituições.» |
| Write Advanced | «Adiciona na Banque Horizon um suporte “Conta Obras” […] detido a 100% por Benoît Martin.» |
| Modelo e backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Os três modelos falham nos dois casos Write. O primeiro pedia para adicionar uma instituição; nenhum concluiu a alteração. O segundo pedia para alterar diretamente um valor derivado da cotação do ouro: os modelos deveriam ter explicado claramente que esta escrita isolada não era suportada, mas os seus percursos prolongaram-se até aos limites de geração ou das ferramentas.
Algumas respostas que nos surpreenderam
Exemplo 1 — uma excelente resposta avançada
À pergunta sobre o objetivo «Reforma tranquila», o Ministral e o Gemma encontram os dois valores esperados. O Ministral responde, nomeadamente:
«Progresso atual: 29,67% […] Esforço mensal necessário: 858,88 €.»
A resposta é curta, quantificada e baseada no percurso de consulta correto.
Exemplo 2 — uma resposta plausível… mas errada
O Qwen responde que a proporção dos ativos financiada pelo passivo é de 13,70% com Vulkan e 15,94% com CUDA, quando o valor esperado é 17,81%. Os cálculos parecem credíveis, mas o modelo omite uma parte do passivo ou escolhe um denominador errado.
Este erro ilustra por que motivo o aspeto convincente de uma resposta financeira não é suficiente.
Exemplo 3 — quando a utilização das ferramentas faz a diferença
Perante o pedido de criação do suporte bancário «Conta Obras», o Gemma aplica exatamente todos os campos pedidos tanto com Vulkan como com CUDA: instituição, moeda, referência, depósito, acompanhamento, proprietário e nota.
O Ministral cria um suporte, mas omite a instituição e a nota no efeito efetivamente registado, apesar de a resposta afirmar o contrário. O Qwen não aplica qualquer alteração. Este exemplo mostra por que a revisão das escritas deve incidir sobre o estado registado, e não apenas sobre o texto final.
Resultados — velocidade real no My Wealth
Tempo de resposta
| Configuração | Média | Mediana | Mínimo | Máximo |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vencedor em velocidade
O Qwen 3.5 9B com CUDA é o mais rápido, tanto em média como na mediana. O Gemma CUDA merece uma explicação: a sua mediana é ligeiramente melhor do que com Vulkan, mas um caso gerou 8 192 tokens durante uma fase de planeamento e durou 4 min 33 s. Este incidente eleva a média para 43,1 s.
Vulkan vs CUDA
Geração: tokens por segundo
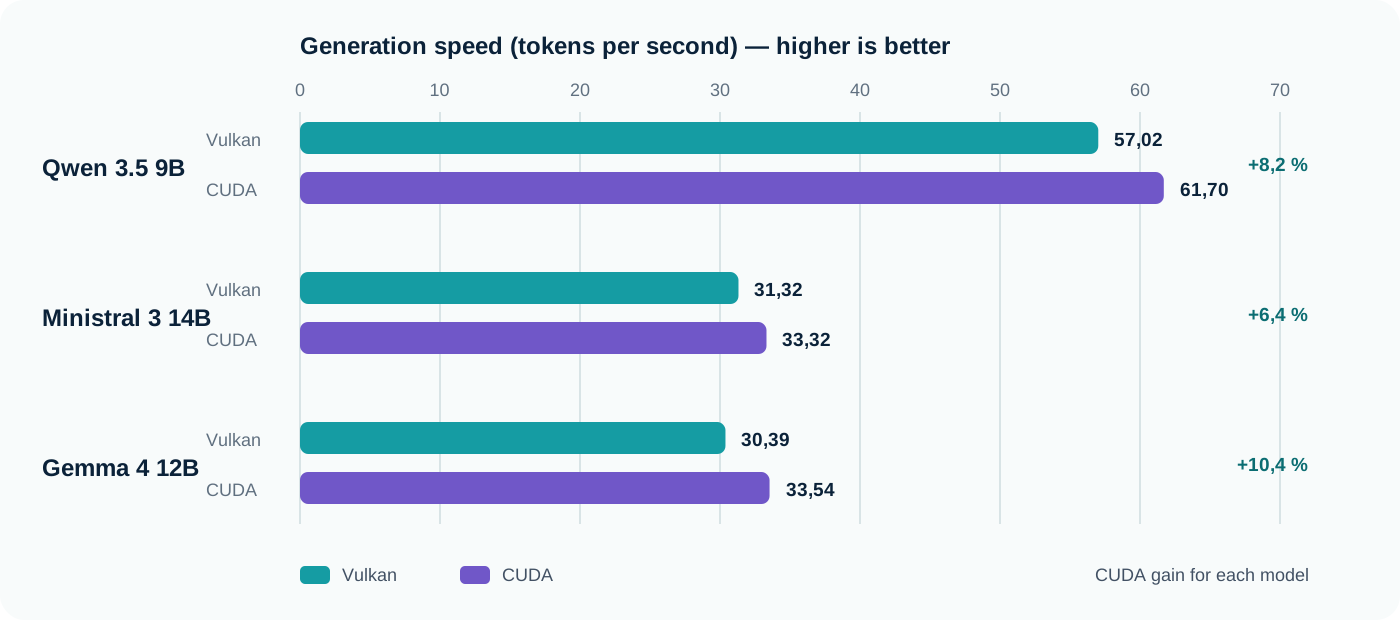
O débito é agregado dividindo o total de tokens gerados pela duração total da geração medida pelo llama.cpp. Não se trata de uma média simples dos débitos de cada fase.
| Modelo | Vulkan | CUDA | Ganho do CUDA |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2% |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4% |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4% |
O CUDA ganha no débito bruto para os três modelos. No entanto, isso não garante um tempo total melhor: as decisões do modelo e as chamadas a ferramentas pesam muitas vezes mais do que alguns tokens por segundo.
Tempo médio de resposta
O CUDA reduz o tempo médio do Qwen em cerca de 7% e o do Ministral em cerca de 9%. Para o Gemma, o incidente de planeamento faz aumentar a média em 56%, enquanto a mediana diminui cerca de 5%. Aqui, a mediana descreve melhor o comportamento habitual; o máximo recorda que um assistente local pode, ocasionalmente, entrar numa geração muito longa.
O vencedor não é necessariamente o modelo mais rápido
O Qwen produz quase o dobro dos tokens por segundo dos outros dois modelos, mas a sua avaliação humana é claramente inferior. O Ministral oferece uma melhoria importante na qualidade sem aumentar excessivamente a espera. O Gemma obtém a melhor pontuação e conclui com sucesso a única escrita avançada nos dois backends, à custa de uma velocidade bruta menor e de um incidente longo com CUDA.
Não calculamos uma pontuação composta arbitrária. Nem todas as utilizações atribuem o mesmo valor a um segundo poupado, a uma resposta exata ou a uma ação corretamente executada.
Que modelo escolher?
Para privilegiar a velocidade
Qwen 3.5 9B Q4_K_M com CUDA. É rápido e requer muito menos memória, mas o resultado de 8/15 exige uma verificação atenta assim que o pedido ultrapassa uma consulta simples.
Para obter o melhor equilíbrio
Ministral 3 14B Q5_K_M com CUDA. A sua pontuação mantém-se em 11/15 nos dois backends e o CUDA reduz a mediana para 18,9 s. É um compromisso sólido para consultas e análises.
Para privilegiar acima de tudo a qualidade
Gemma 4 12B Q6_K com Vulkan. Com 13/15 e a ação avançada concluída, vence este comparativo. O Gemma obtém a mesma pontuação com CUDA, mas o Vulkan evita o incidente de planeamento que prolonga consideravelmente a média do CUDA.
Conclusão
Nesta RTX 5060 Ti de 16 GB, nenhum modelo domina todos os critérios.
O Qwen é o campeão da velocidade. O Ministral oferece o compromisso mais regular entre espera e qualidade. O Gemma com Vulkan apresenta os melhores resultados funcionais e é o mais convincente nos percursos complexos.
A escolha depende, portanto, da necessidade: resposta rápida para consultas simples, equilíbrio para um assistente quotidiano ou prioridade máxima à qualidade e às ações. No nosso comparativo, o Gemma 4 12B Q6_K vence em qualidade nos dois backends; preferimos o Vulkan pela sua regularidade. O Qwen 3.5 9B Q4_K_M com CUDA vence em velocidade.