Qwen 3.5 9B vs Ministral 3 14B vs Gemma 4 12B: test av lokala LLM på RTX 5060 Ti
Små språkmodeller har gjort enorma framsteg. Det går nu att köra modeller lokalt på ett grafikkort för konsumentbruk och låta dem söka i en förmögenhet, sammanföra flera uppgifter eller förbereda en åtgärd i en applikation.
Men en fråga är mer användbar än en rangordning av benchmarkresultat:
Nyckelfråga: vilken modell fungerar faktiskt bäst i en applikation som My Wealth?
Vi jämförde tre konfigurationer som erbjuds i My Wealths AI-profiler:
| My Wealth-profil | Modell | Testad kvantisering |
|---|---|---|
| Basic/2 | Qwen 3.5 9B | Q4_K_M |
| Medium/1 | Ministral 3 14B Instruct 2512 | Q5_K_M |
| Medium/2 | Gemma 4 12B | Q6_K |
Antalet token per sekund spelar roll, men viktigast är ett korrekt svar som bygger på portföljens data och tas fram med rätt verktyg. Därför jämför vi funktionell framgång, svarskvalitet, tidsåtgång och prestanda med Vulkan och CUDA.
Testdatorn
Alla modeller kördes lokalt på samma dator.
Grafikkort
NVIDIA GeForce RTX 5060 Ti 16 GB tillhör Blackwell-generationen. Dess 16 GB GDDR7 gör att alla tre kvantiserade modellerna i jämförelsen ryms helt i grafikprocessorns minne. NVIDIA erbjuder kortet med 16 GB och 8 GB; vi använde den första versionen. NVIDIAs officiella produktsida
Fullständig konfiguration
| Komponent | Uppmätt konfiguration |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti, 16 311 MiB |
| CPU | AMD Ryzen 5 2600, 6 kärnor och 12 trådar |
| RAM | 31,9 GiB |
| System | Windows 11 Professional, build 26200 |
| NVIDIA-drivrutin | 616.56 |
| Runtime | llama.cpp 0.4.0, build 10809 |
| Kontext | 32 768 token |
| Backend | Först Vulkan, sedan CUDA |
Bildmodulen i varje modell var avstängd. De femton fallen är uteslutande textbaserade, och inställningen gör att en oanvänd komponent inte upptar minne. Den högsta observerade användningen av grafikminne under körningarna var ungefär 7,7 GiB för Qwen, 15,8 GiB för Ministral och 12,0 GiB för Gemma.
De tre modellerna
Qwen 3.5 9B — den mycket snabba lilla modellen
Qwen 3.5 9B är den mest kompakta av de tre. Det officiella kodförrådet presenterar den som en multimodal samtalsmodell med Apache 2.0-licens. I vårt textbaserade test ger den mindre storleken en tydlig hastighetsfördel. Officiell sida för Qwen 3.5 9B
I det här testet
Vi använder Qwen i Q4_K_M. Det är den mest lättillgängliga och snabbaste konfigurationen i jämförelsen. Den klarar direkta förfrågningar väl, men är mindre konsekvent när orkestreringen eller skrivåtgärden blir komplex.
Ministral 3 14B Instruct 2512 — Mistral AI:s edge-modell
Ministral 3 14B är den största modellen i testet. Mistral riktar den bland annat mot lokala installationer och edge-miljöer. Instruct-versionen stöder elva språk och använder Apache 2.0-licensen. Officiell sida för Ministral 3 14B Instruct
I det här testet
Vi använder Ministral i Q5_K_M. För en symmetrisk jämförelse mellan Vulkan och CUDA, och för att undvika minnesproblemet med dess tidigare runtime, använder båda körningarna samma llama.cpp 0.4.0-motor som Gemma, utan bildmodul. Modellen använder nästan hela det tillgängliga minnet på 16 GB, men förblir stabil.
Gemma 4 12B — högst poäng i jämförelsen
Gemma 4 12B är en multimodal modell från Google med Apache 2.0-licens. Den officiella sidan beskriver inmatning av text, ljud, bild och video; här använder vi endast textdelen. Officiell sida för Gemma 4 12B
I det här testet
Vi använder Gemma i Q6_K. Storleken gör att den kan behålla högre precision än Ministral Q5 och ändå hålla sig inom kortets minnesram. Det är också den enda deltagaren som klarar den avancerade åtgärden.
Kvantisering som anpassning till maskinvaran
De tre modellerna testas inte med samma kvantisering: Q4_K_M för Qwen, Q5_K_M för Ministral och Q6_K för Gemma. Valet motsvarar de profiler som faktiskt går att använda i My Wealth och deras avsedda maskinvara.
| Modell | Kvantisering | Högsta observerade GPU-minne |
|---|---|---|
| Qwen 3.5 9B | Q4_K_M | 7,7 GiB |
| Ministral 3 14B | Q5_K_M | 15,8 GiB |
| Gemma 4 12B | Q6_K | 12,0 GiB |
Det här benchmarktestet jämför alltså produktkonfigurationer. Resultaten gör inte anspråk på att isolera enbart modellernas arkitektur.
My Wealths testprotokoll
My Wealths fullständiga testbänk innehåller 354 frågor och åtgärder. Vi låste 15 av dem innan några mätningar gjordes:
| Kategori | Antal | Syfte |
|---|---|---|
| Basic | 8 | Direkta frågor om förmögenheten |
| Intermediate | 2 | Sammanställning av flera uppgifter |
| Advanced | 2 | Mer avancerad analys och verktygsflöden |
| Write | 2 | Enkel åtgärd eller säker vägran av en omöjlig åtgärd |
| Write Advanced | 1 | Fullständig registrering med flera fält |
| Totalt | 15 |
Varje konfiguration behandlade exakt samma fall, först med Vulkan och sedan med CUDA. En modell låg kvar i minnet under sina femton tester. En uppvärmningskörning räknades inte in, och den syntetiska förmögenheten och samtalet återställdes inför varje fall. Endast ett uppmätt försök behölls; ett modellfel är fortfarande ett resultat.
Vad vi mäter
1. Funktionell framgång
Alla 90 resultat granskades manuellt. För en fråga bedömer vi om det synliga svaret är korrekt och fullständigt i förhållande till de syntetiska uppgifterna. Ett överflödigt verktygsanrop gör inte ett bra svar till ett misslyckande. För en skrivåtgärd kontrollerar vi den faktiskt sparade effekten och vart och ett av de efterfrågade fälten: ett påstående om framgång räcker inte.
2. Svarskvalitet
Vi granskar de synliga svaren separat: korrekthet, tydlighet, trohet mot uppgifterna och användbarhet. Den mänskliga granskningen avgör den publicerade poängen.
3. Svarstid
Den totala tiden omfattar val av verktyg, planering, verktygsanrop och det slutliga svaret. Den speglar den upplevda väntetiden bättre än en isolerad genereringshastighet.
4. Vulkan mot CUDA
För varje modell använder de två körningarna samma GGUF-fil, samma mall, samma motor och samma parametrar. Endast GPU-backend ändras.
Resultat — svarens kvalitet
Samlat resultat
| Konfiguration | Vulkan | CUDA |
|---|---|---|
| Qwen 3.5 9B Q4_K_M | 9/15, det vill säga 60 % | 8/15, det vill säga 53 % |
| Ministral 3 14B Q5_K_M | 11/15, det vill säga 73 % | 11/15, det vill säga 73 % |
| Gemma 4 12B Q6_K | 13/15, det vill säga 87 % | 13/15, det vill säga 87 % |
Vinnare i kvalitet
Gemma 4 12B Q6_K får bäst resultat med båda backend-alternativen, med 13 lyckade fall av 15. Ministral kommer tvåa med 11/15. Qwen får 9/15 med Vulkan och 8/15 med CUDA.
Resultat per kategori
Här är ett konkret exempel på en testad begäran i varje kategori:
| Kategori | Exempel på testad begäran |
|---|---|
| Basic | ”Vad är det totala beloppet för mina skulder?” |
| Intermediate | ”Jämför värdet på mitt sparande med värdet på mina skulder.” |
| Advanced | ”Vad är den aktuella utvecklingen och den nödvändiga månatliga insatsen enbart för målet Trygg pension?” |
| Write | ”Lägg till ‘Crédit Mutuel’ bland mina institut.” |
| Write Advanced | ”Lägg till innehavet ‘Compte Travaux’ hos Banque Horizon […] som ägs till 100 % av Benoît Martin.” |
| Modell och backend | Basic /8 | Intermediate /2 | Advanced /2 | Write /2 | Write Advanced /1 |
|---|---|---|---|---|---|
| Qwen Vulkan | 6 | 2 | 1 | 0 | 0 |
| Qwen CUDA | 5 | 2 | 1 | 0 | 0 |
| Ministral Vulkan | 7 | 2 | 2 | 0 | 0 |
| Ministral CUDA | 7 | 2 | 2 | 0 | 0 |
| Gemma Vulkan | 8 | 2 | 2 | 0 | 1 |
| Gemma CUDA | 8 | 2 | 2 | 0 | 1 |
Alla tre modellerna misslyckas i de två Write-fallen. I det första skulle ett institut läggas till; ingen slutförde ändringen. I det andra skulle ett värde som härletts från guldpriset ändras direkt. Modellerna borde tydligt ha förklarat att en sådan isolerad skrivåtgärd inte stöddes, men deras flöden fortsatte tills gränsen för generering eller verktyg nåddes.
Några svar som överraskade oss
Exempel 1 — ett utmärkt avancerat svar
På frågan om målet ”Trygg pension” hittar Ministral och Gemma de två förväntade värdena. Ministral svarar bland annat:
”Aktuell utveckling: 29,67 % […] Nödvändig månatlig insats: 858,88 euro.”
Svaret är kort, sifferbaserat och grundat i rätt frågeflöde.
Exempel 2 — ett rimligt svar… som är fel
Qwen svarar att andelen tillgångar som finansieras av skulder är 13,70 % med Vulkan och 15,94 % med CUDA, medan det förväntade värdet är 17,81 %. Beräkningarna verkar trovärdiga, men modellen utelämnar en del av skulderna eller väljer fel nämnare.
Felet visar varför en övertygande form på ett finansiellt svar inte räcker.
Exempel 3 — när verktygsanvändningen gör skillnad
När bankinnehavet ”Compte Travaux” ska skapas tillämpar Gemma exakt alla efterfrågade fält med både Vulkan och CUDA: institut, valuta, referens, insättning, uppföljning, ägare och anteckning.
Ministral skapar ett innehav men utelämnar institutet och anteckningen i den faktiskt sparade effekten, trots att svaret hävdar motsatsen. Qwen gör ingen ändring. Exemplet visar varför skrivåtgärder måste granskas utifrån det sparade tillståndet, inte bara sluttexten.
Resultat — verklig hastighet i My Wealth
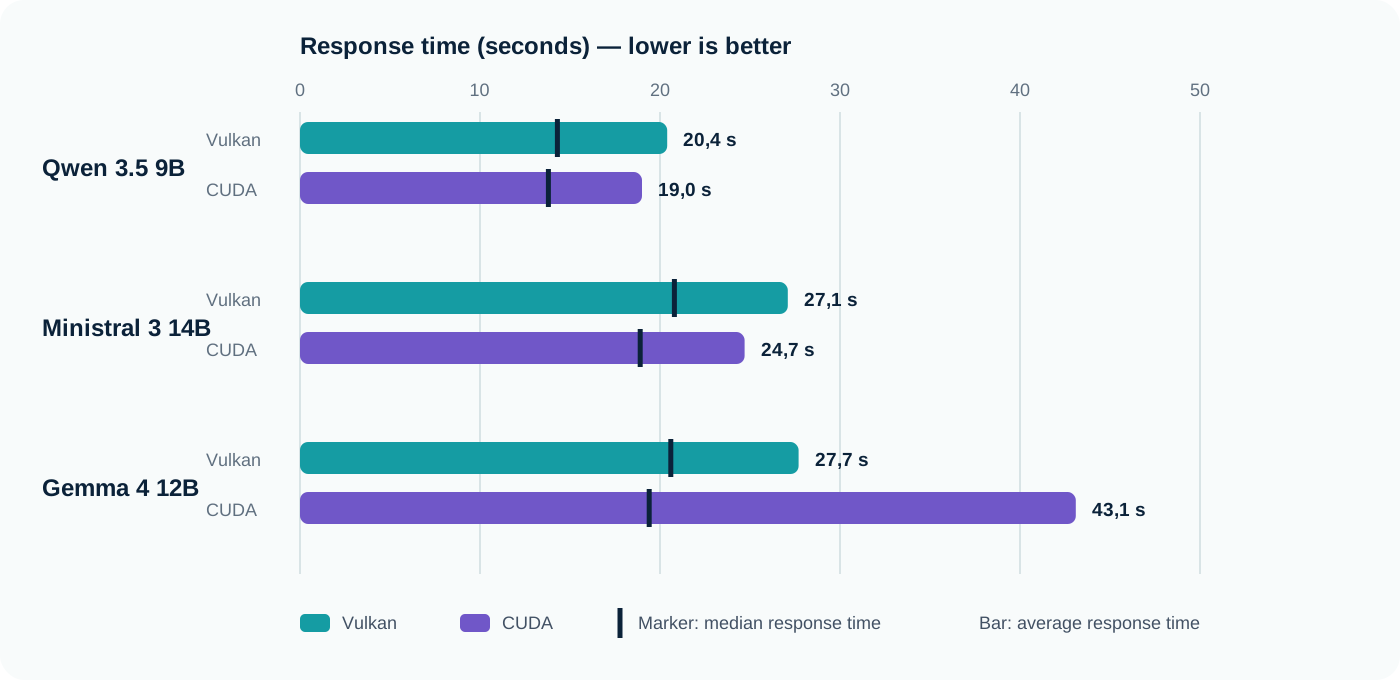
Svarstid
| Konfiguration | Genomsnitt | Median | Minimum | Maximum |
|---|---|---|---|---|
| Qwen Vulkan | 20,4 s | 14,3 s | 11,6 s | 55,4 s |
| Qwen CUDA | 19,0 s | 13,8 s | 10,9 s | 52,4 s |
| Ministral Vulkan | 27,1 s | 20,8 s | 12,9 s | 109,5 s |
| Ministral CUDA | 24,7 s | 18,9 s | 11,7 s | 102,0 s |
| Gemma Vulkan | 27,7 s | 20,6 s | 12,8 s | 107,0 s |
| Gemma CUDA | 43,1 s | 19,4 s | 12,3 s | 273,3 s |
Vinnare i hastighet
Qwen 3.5 9B med CUDA är snabbast, både i genomsnitt och sett till medianen. Gemma CUDA behöver en förklaring: medianen är något bättre än med Vulkan, men i ett fall genererades 8 192 token under en planeringsfas och processen tog 4 min 33 s. Den händelsen höjer genomsnittet till 43,1 s.
Vulkan vs CUDA
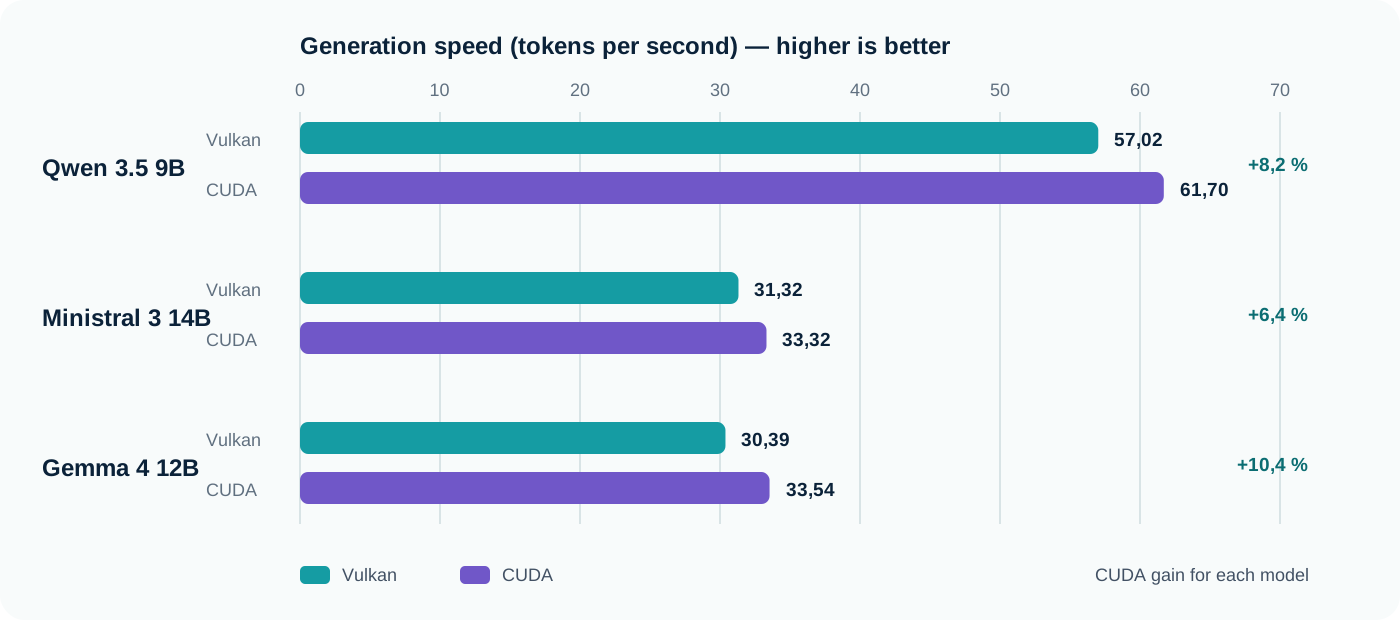
Generering: token per sekund
Hastigheten aggregeras genom att det totala antalet genererade token delas med den totala genereringstiden som uppmätts av llama.cpp. Det är inte ett enkelt genomsnitt av hastigheten i varje fas.
| Modell | Vulkan | CUDA | CUDA-vinst |
|---|---|---|---|
| Qwen 3.5 9B | 57,02 tok/s | 61,70 tok/s | +8,2 % |
| Ministral 3 14B | 31,32 tok/s | 33,32 tok/s | +6,4 % |
| Gemma 4 12B | 30,39 tok/s | 33,54 tok/s | +10,4 % |
CUDA vinner i rå genomströmning för alla tre modellerna. Det garanterar dock inte en bättre totaltid: modellens beslut och verktygsanrop väger ofta tyngre än några token per sekund.
Genomsnittlig svarstid
CUDA minskar Qwens genomsnittliga tid med cirka 7 % och Ministrals med cirka 9 %. För Gemma ökar planeringsincidenten genomsnittet med 56 %, samtidigt som medianen sjunker med cirka 5 %. Medianen beskriver det vanliga beteendet bättre här; maxvärdet påminner om att en lokal assistent ibland kan hamna i en mycket lång generering.
Vinnaren är inte nödvändigtvis den snabbaste modellen
Qwen producerar nästan dubbelt så många token per sekund som de andra två modellerna, men den mänskliga bedömningen är betydligt lägre. Ministral ger en tydlig kvalitetsförbättring utan att försämra väntetiden alltför mycket. Gemma får bäst poäng och klarar den enda avancerade skrivåtgärden med båda backend-alternativen, till priset av lägre råhastighet och en lång incident med CUDA.
Vi beräknar inget godtyckligt sammansatt resultat. Alla användningsområden värderar inte en sparad sekund, ett korrekt svar eller en korrekt utförd åtgärd lika högt.
Vilken modell ska du välja?
När hastighet är viktigast
Qwen 3.5 9B Q4_K_M med CUDA. Den är snabb och kräver betydligt mindre minne, men resultatet 8/15 innebär att svaret bör kontrolleras noggrant så snart begäran är mer avancerad än en enkel fråga.
För den bästa balansen
Ministral 3 14B Q5_K_M med CUDA. Poängen ligger kvar på 11/15 med båda backend-alternativen och CUDA sänker medianen till 18,9 s. Det är en stabil kompromiss för frågor och analyser.
När kvalitet är allra viktigast
Gemma 4 12B Q6_K med Vulkan. Med 13/15 och en lyckad avancerad åtgärd vinner den jämförelsen. Gemma får samma poäng med CUDA, men Vulkan undviker planeringsincidenten som höjer CUDA-genomsnittet kraftigt.
Slutsats
På detta RTX 5060 Ti 16 GB dominerar ingen modell samtliga kriterier.
Qwen är hastighetsmästaren. Ministral erbjuder den jämnaste avvägningen mellan väntetid och kvalitet. Gemma med Vulkan ger bäst funktionella resultat och är mest övertygande i komplexa flöden.
Valet beror därför på behovet: snabba svar på enkla frågor, balans för en daglig assistent eller högsta prioritet för kvalitet och åtgärder. I vår jämförelse vinner Gemma 4 12B Q6_K i kvalitet med båda backend-alternativen; vi föredrar Vulkan för dess jämnhet. Qwen 3.5 9B Q4_K_M med CUDA vinner i hastighet.